CH32 PIOC入门(三):原来还要自己烤?当 MCU 没有你需要的外设
PIOC 不只是用来模拟 UART、I2C、1-Wire 的“小外设”。当我们把一个完全没有对应硬件外设的两线数字接口交给 PIOC 之后,它真正像的东西,或许不是“协议模拟器”,而是一种 Software Defined Peripheral。
01 前言
01.1 MCU 上没有这个外设怎么办
在嵌入式开发中,常常需要与各种外部芯片或设备通讯。许多外部组件都使用常见的通信接口,如 UART、SPI、I2C 等,大部分主流 MCU 也都提供了这些数字接口的外设。然而,有时还是会不可避免地遇到这样的问题:某个外部组件需要的接口并不是常见的各种数字接口,也与 MCU 所提供的数字接口不完全兼容。更加烦人的是,这个数字接口可能只是一两条信号线的简单协议实现,但却有严格的时序要求。
也许一些读者看到这里的时候就想到了,WS2812、DS18B20、NEC 红外遥控、433M OOK 无线遥控等,都属于这类情况。这些协议本身并不复杂,但都对绝对定时有严苛的要求。而且,这些数字接口往往无法通过现有的 MCU 外设直接实现。于是,工程师们就不得不自己想办法去解决这个问题。
许多时候,这些数字单双线协议不被主流 MCU 所支持,并不是因为它们本身有多复杂,而是因为它们的实现百花齐放、百家争鸣,很难归并成一种固定的硬件实现,厂商难以为每一种数字接口都设计一套硬件外设。于是,工程师们就不得不自己想办法,各显神通,去解决这个问题。
而无论是 IO 模拟、TIM/SPI+DMA 等等,这些办法共同缺的其实是同一个东西:能处理万花筒一般的各式各样 IO 时序、不需要 CPU 亲自盯着每一个 bit,甚至同时能根据输入进行一些简单的状态判断。
01.2 要不,自己烤一个
既然现成的办法都总是差一点点,那么:要不,自己烤一个?
别笑,这不是说让读者买一些沙子回来烤芯片。网络上流传着这样一个梗:有人给 Linux 过生日,递上一只精心包装的“生日蛋糕”,拆开一看,里面是面粉、牛奶、鸡蛋、黄油、糖和酵母等原料,附带一张小纸条写着:“你自己编译去吧”。把这个梗搬到这里正合适:常规的 MCU 外设,是厂家把“蛋糕”烤好了端上桌;而我们这几篇文章谈论的 PIOC,正如这个“Linux 的生日蛋糕”一样,只给了原料和烤箱。
这并不意味着 PIOC 是一个被直接端给用户的“半成品”,而是说 PIOC 提供了一个强实时的、自由定义的 IO 控制单元。前文中我们已经提到过,它提供了一个小型的、独立的 CPU,配合 GPIO、时序控制、条件判断和状态转换等功能,让用户可以自己实现自己所需要的数字接口。
从这个意义上来说,PIOC 给了我们“蛋糕”的原料和烤箱,但是没有规定菜谱,对吧?
那我为啥还要照着资料包里的“菜谱”烤呢?
不过如果这一篇还是写“如何用 PIOC 实现 XXX 协议”,大概率又会被读者吐槽我在大力灌水(划掉)那就和第二篇没有太大的区别。我们也许可以尝试看看表象之下,还有什么有趣的东西。
02 PIOC 到底给了我们什么
02.1 PIOC 不只是协议模拟器
在本系列前两篇中,我们已经从两个角度认识了 PIOC。第一篇从 PIOC 的硬件结构和开发流程入手,介绍了如何编写、加载和运行 PIOC 程序;第二篇则选取 DS18B20 作为实例,从 1-Wire 时序开始,将一个实际协议完整翻译成 PIOC 汇编,并最终封装成主核可以直接调用的接口。这两篇所解决的问题,本质上都是“一个已经存在的数字协议,应该如何交给 PIOC 来实现”。
到这里,相信不少读者对 PIOC 的印象是这样的:一个“协议模拟器”。官方例程里有 UART,就照着 UART 写;有 I2C,就照着 I2C 写;有 1-Wire,就照着 1-Wire 写:资料包里提供什么协议例程,我们就能用它做什么。
这种理解没错,但它很容易让人忽略一些更重要的问题:PIOC 究竟是在“实现协议”,还是在“实现一种可以由软件描述的 IO 行为”?
这些协议之所以能够被 PIOC 实现,是因为 PIOC 支持 UART、I2C 和 1-Wire 吗?显然不是,PIOC 根本没有这些外设的硬件模块。我们真正写进去的,只是一段程序:在什么时候把 IO 拉高/拉低、在什么时候采样输入、等待几个周期、如何根据条件跳转,只是这段程序表现出来的行为,完全符合这些协议要求。
换句话说,第二篇真正证明的并不只是“PIOC 能驱动 DS18B20”,更进一步来说应该是“一个数字协议的时序和波形规则,可以被写成 PIOC 程序”。
那么就不得不面对以下问题:
- PIOC 到底给了我们什么?
- 为什么一个芯片手册里没有的数字外设,可以在 PIOC 上被“写出来”?
- 如果已经有了在 CPU 上的软件实现,我们又能不能把它变成一个 PIOC 实现的外设?
02.2 做数字协议并不是 PIOC 的边界
我们已经知道 PIOC 能做 UART、I2C、1-Wire、WS2812 等各种数字协议,而这些协议之间的差异并不在于它们的名字,而在于它们对信号行为的规定:什么时候输出、什么时候采样、等待多久、根据什么条件进入下一种状态。从主核的视角来看,UART、I2C、1-Wire 是不同的协议;但对 PIOC 来说,它们最终都必须被翻译成 IO 操作、时序控制以及状态转移。
如果基于这个角度来进行讨论,所谓 UART、I2C、1-Wire,实际上都只是对一组数字 IO 时序和状态转移规则的不同描述。PIOC 并不需要“认识”这些协议的名字,它只需要执行那段能够产生正确 IO 行为的程序。也就是说,PIOC 真正能做的,其实并不只是我们从资料包的例程中看到的“实现好几种协议”,从更底层的角度来说是执行一段描述 IO 行为的程序。
那么就很容易产生这样的想法:是不是任何能被描述成 IO 时序的数字接口,都可以交给 PIOC 来实现呢?
还真不一定。尽管理论上来说 PIOC 的指令集已经具备条件分支、循环、间接寻址等基本的程序控制能力,因此从表达能力上看,它并不要求目标 IO 行为必须属于某一种预定义协议。只要这种行为能够被它有限的程序空间、数据处理能力和 IO 资源表达,就有机会由 PIOC 实现。但是实际应用中,PIOC 仍然受到程序空间、指令能力、IO 数量、数据处理能力和执行速度等资源限制。
我们甚至不需要为某个协议专门发明一种 PIOC 实现。如果已经存在一种能够在 CPU 上运行的软件实现,那么其中负责精确操纵 IO、且能够与上层逻辑解耦的部分,理论上就有机会被进一步下沉(offload)到 PIOC。
这就带来了一个比“能不能实现某个协议”更有趣的问题:一个原本运行在主核上的“软件模拟”外设,能不能被搬到 PIOC 中,最终变成一个真正独立运行的外设?
02.3 烤个奇怪的东西试试看
这一次,我们甚至不需要发明一个新的数字协议。恰恰相反,本文中我们选择的这个协议早已有成熟的规范,也早已有成熟的 CPU 软件实现(基于 IO 模拟),而且它在连续操作中会反复执行一个结构高度重复的底层 IO 事务。我们要做的,是从一个已经能够工作的 CPU 实现出发,找到其中最适合由 PIOC 接管的部分,并把它移植过去变成一个独立工作的“外设”。
在第二篇中,我们从手册给出的时序规范从头开始写出了 DS18B20 的 PIOC 程序。而本文我们将从一个已经存在的软件实现出发,找到从设计上期望高实时性 IO 操作的部分,考虑如何把它变成一个 PIOC 程序。
也就是说我们准备利用 PIOC 的特性,自己“烤”一个 MCU 手册里没有,但实际应用中广泛采用软件模拟的数字协议。它并不是某个器件厂商私有的奇怪接口,而是一种已经被广泛采用、存在参考实现的标准协议。
SWD(Serial Wire Debug)是 Arm 官方定义的调试接口协议,广泛用于 Arm Cortex-M 系列 MCU 的调试和编程。SWD 通常使用两根信号线:SWCLK(时钟)和 SWDIO(数据),SWDIO 为双向推挽数据线,通过约定的换向机制进行方向切换。SWD 协议本身定义了完整的调试事务,包括读写寄存器、访问内存、控制调试状态机等操作。由于 version 1 的 SWD 协议在实际应用中最为常见,本文中所涉及的 SWD 协议若无特殊说明,均为 version 1。
SWD 本身并不是一个我们新发明的协议,也不是一个缺乏现成软件支持的协议。Arm 官方提供的 CMSIS-DAP 项目就包含完整的 SWD 后端参考实现。
那么问题来了:如果靠 CPU 软件模拟已经能做,为什么还要“用 PIOC 再烤一个”?CPU 做不到,还是做得不可靠?
还真不是 CPU 做不到,显然 CMSIS-DAP 已经证明了这一点。从官方的 CMSIS-DAP 源码中容易发现,为了实现 SWD 协议与目标 MCU 通信,主要需要以下通信原语:
SWD_Transfer():通过逐位的 GPIO 操作完成 SWD 请求、ACK、数据和换向等时序实现单次 SWD 传输事务SWD_Sequence():(同样是逐位的 GPIO 操作模拟)任意位的比特流输入/输出(Line Reset、SWD 复位序列用)SWJ_Sequence():(同样是逐位的 GPIO 操作模拟)SWJ 线路复位、JTAG 转 SWD 切换序列
因此,如果我们站在普通 MCU 的角度来看,SWD 完全可以被看作一种“已经有现成软件实现的数字接口”,哪怕是通过软件模拟的方式。
不过,本文的叙述重点不是实现一个完整的 DAP 调试桥,所以就不过多展开关于 SWD 协议本身的细节和 DAP 事务的完整实现。但仍然值得提出的一点是,在完整的 CMSIS-DAP 实现中,SWD 事务的底层逐位 IO 操作部分(也就是 IO 模拟实现)集中在 SWD_Transfer() 等协议通信原语中,其内部需要不断进行 GPIO 输出/采样、方向切换、条件判断以及周期控制,而这些操作恰好又是 PIOC 最擅长处理的事情。例如,考虑连续内存访问的工况,SWD_Transfer() 会被大量重复执行,因此自然成为最值得考虑下沉到 PIOC 的热路径。由于本文不是《教你用 CH32V205 做 DAP 调试器》,故仅将这个“热路径”作为下沉到 PIOC 的对象,而不是全部的相关通信原语。
于是,我们可以尝试做一件很有意思的事情:既然我们已经在前面的文章里总结出“命令-响应”式的调用约定,是否就可以不再让主核亲自执行软件模拟实现的 SWD_Transfer(),改为在 PIOC 上来执行 SWD_Transfer() 这段“数字时序程序”?
这样一来,主核中的 DAP 业务逻辑调用的仍然是:
1 | ack = SWD_Transfer(request, &data); |
但此时这个函数不再是 CMSIS-DAP 源码中的 IO 模拟 SWD 程序,它已经变成了调用一个由 PIOC 独立执行的“SWD 外设”实现通信的函数,这就是我们本文想“烤”的东西。
那么,一个看起来只是几百行汇编的 PIOC 程序,究竟在什么时候开始算“一个外设”?
03 PIOC 和树莓派的 PIO
这个问题笔者在后台不止一次看到有读者好奇。
PIO,PIOC,乍一看就像是差不多的东西。它们都被定义为一种 Programmable I/O 组件,都可以用于处理 IO 时序,都可以减轻主 CPU 的实时负担,所以被一起讨论是完全合理的,因为从作用来看确实很像。
但它们一样吗?并非。它们只是在设计理念上相似,在实现上则各有不同。
在笔者看来,树莓派的 PIO 更像是多个高度特化的 IO 控制状态机,而 CH32 上的 PIOC 更像是一颗 MCU 片上的、专门负责数字 IO 的小型 CPU。这听起来似乎只是架构实现上的细节差异,但实际上意味着它们有几乎完全不同的编程模型。
我们先看许多人首先容易想到的树莓派 PIO,再看 CH32 的 PIOC,最后回答一个问题:既然两者差了这么多,为什么大家还是习惯把它们放在一起讨论?
03.1 PIO:主核旁边的一排状态机
以 RP2040 为例,其内部有两个 PIO 块,每个 PIO 块包含 4 个状态机,总共提供 8 个可以独立运行的 PIO 状态机。也就是说,如果把 RP2040 的两个 Cortex-M0+ 核心看作 MCU 的“主核”,那么 PIO 更像是在主核旁边又放了 8 个非常迷你的“IO 控制器”。
Raspberry Pi 官方文档对 PIO 的描述也非常有意思:这些状态机可以像处理器一样执行短小的顺序程序,但它们又不是通用处理器,而是高度专门化于 IO,重点就是确定性、精确时序以及与固定硬件的紧密结合。这些状态机的程序非常短,也非常专用化,每个状态机都有自己的程序计数器、X/Y 寄存器、输入输出移位寄存器和 FIFO,同一个 PIO 块内的几个状态机共享指令存储器等硬件资源。
PIO 的指令集被描述为一组专门服务于 IO 的操作,例如 IN、OUT、PUSH、PULL、MOV、JMP、WAIT 等。它们虽然具备条件判断和程序跳转能力,但这种“处理器”的设计目标从一开始就不是运行一般意义上的通用程序,而是控制 GPIO、位操作、等待某个输入状态,并按照严格的时序不断重复这些动作。
因此,从结构上看,RP2040 中的 PIO 更像这样:
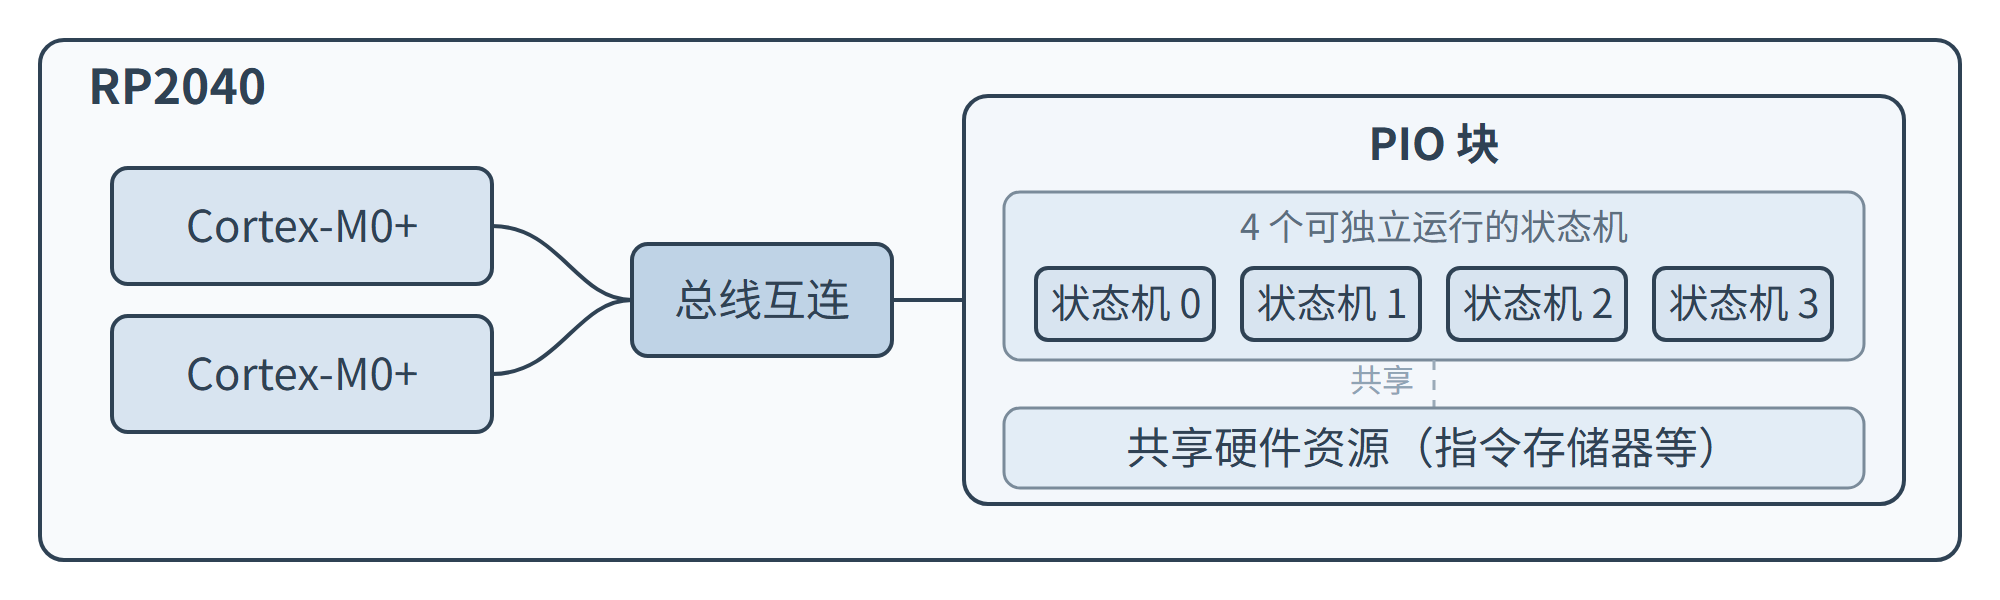
四个状态机共享所在的 PIO 块中的程序存储器和部分硬件资源,每个状态机都可以独立运行自己的 IO 程序。因此,它很适合用于“一个复杂的数字接口需要多个彼此配合的时序条件”的场景,也很适合“多个简单接口并行工作”的场景。官方文档中甚至直接把“4 个状态机独立执行短程序”作为 PIO 的核心特征之一。
03.2 PIOC:主核旁边的一颗小 CPU
根据目前能够获得的公开资料和现有的工具链,CH32 的 PIOC 使用的是 RISC8B 指令集,大多数指令为单周期执行,只有跳转或少数指令需要多周期;其拥有独立的程序存储空间、SFR、自己的寄存器和栈,并提供两个 IO 的控制能力。
也就是说,PIOC 更像主核旁的一个专用于 IO 控制的协处理器:
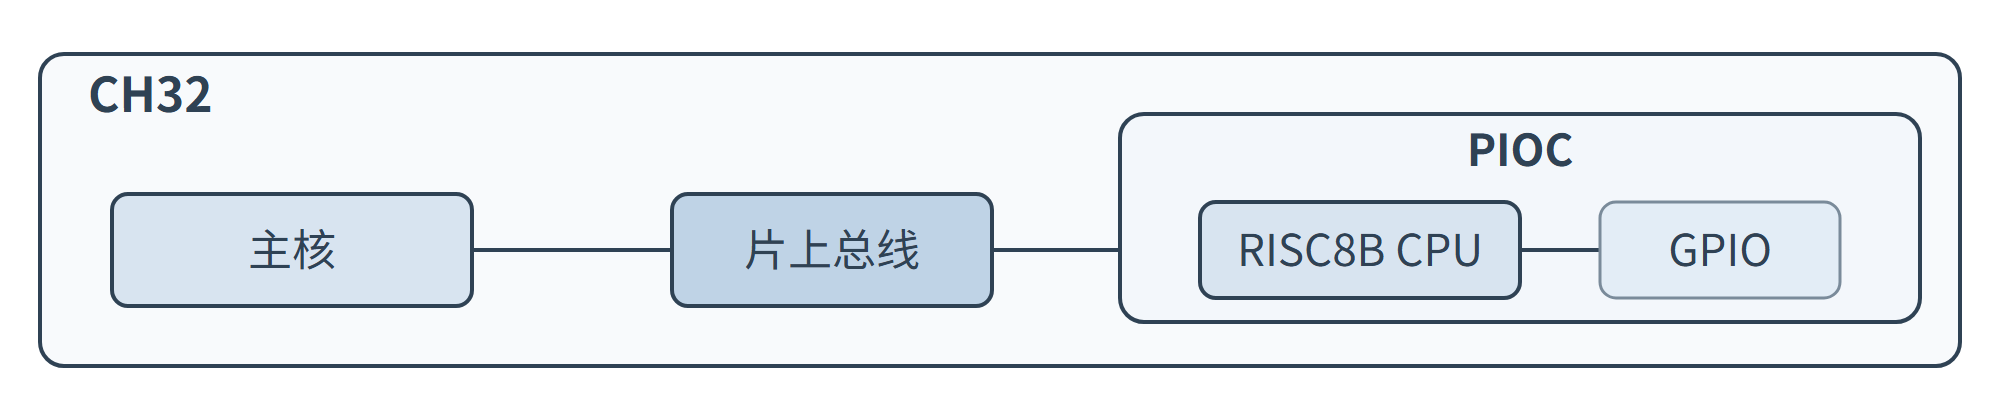
如果拿一个传统 MCU 的资源规模来衡量,哪怕是以 89C51 这样的经典 8 位 MCU 作为参照,它也显得非常“寒酸”。PIOC 没有常规处理器内核那样丰富的寄存器和指令体系,也没有庞大的地址空间,甚至连独立的 RAM 都没有,以至于需要依赖 SFR 或栈来实现 RAM 暂存数据的功能。高性能计算之类的应用,就更不用想了。但从编程模型上来说,我们写入 ROM 空间的确实是一段一般意义上的 CPU 程序:可以访问 SFR,可以进行算术和逻辑运算,可以根据条件跳转,可以循环,可以间接寻址,也可以主动修改程序流程。
因此,它并不是状态机的自由组合,笔者还是认为用“特化的、高度简洁的 IO 协处理器”来描述 PIOC 更为准确。两者能实现的功能相似,但内在的结构与设计思想并不完全一样,一个把“状态机”作为硬件执行单元,一个把“处理器”作为硬件执行单元。可以这样打个不恰当的比方:
- PIO: 一组为 IO 操作高度优化的硬件状态机,用户通过程序编排它们的行为。
- PIOC: 一个为 IO 操作高度优化的小 CPU,用户直接编写程序。
当然,这并不是说“PIO 不能写程序”或“PIOC 没有状态机”。实际应用中的 PIO 状态机本身就是通过程序来定义行为的;而 PIOC 的程序为了可靠处理不同阶段的 IO,同样会表现出非常明显的状态机特征。
另一方面,两者与主核的数据交换也有设计上的不同。PIO 在设计时引入了 FIFO 和 DMA,主核可以把数据写进状态机的 FIFO,由 PIO 程序取走;处理完成的数据被写入 FIFO,由主核或 DMA 再取回。而 PIOC 则更接近一个“主核看着像外设的小 CPU”,并且它无法直接读写主核的内存,能访问的只有它自己那组 SFR。所以在本文前面的例子里,主核把命令和数据写入 PIOC 的通用 SFR,PIOC 执行程序后再通过 SFR 传回结果和数据。主核与 PIOC 交互的过程常常是这样的:
- 主核:给我发数据“xxxxxxxx”。
- PIOC:(执行一段程序来完成整个时序)搞好了。
- 主核:收到。
这更接近我们在上一篇文章中采用的“命令-响应”模型。
也就是说,PIO 交出来的是一组状态机加 FIFO/DMA 的数据通路,PIOC 交出来的是一个“主核看着像外设”的小 CPU。两者能实现的功能相似,但在硬件执行单元、编程模型和数据交换方式上,走的完全是两条路。
03.3 相似还是不同?
结构上差了这么远,为什么大家还是习惯把两者放在一起讨论?因为它们瞄准的是同一个老问题。对于一般的 MCU 来说,直接使用 CPU 处理一个严格时序的数字接口,通常意味着大量 CPU 时间被用在“亲自执行 IO 工作”上。以最简单的 GPIO 模拟(bit-bang)为例,主 CPU 需要消耗自己的时钟周期执行指令来完成以下序列:
- 写 GPIO
- 等待
- 读取 GPIO
- 逻辑判断
- 再写 GPIO
- 再等待
- (如此重复)
如果时序要求不高,这种方式完全没有问题。但一旦协议变得复杂,或者时序要求严格,或者主核同时还要处理各种任务,主核就会越来越不自由,场面可能会变成这样:
- 中断:喂!USB EP1OUT 来数据了,赶紧拿走然后决定要不要 NAK!
- 其它任务:楼上磨蹭半天了,在那玩什么呢?
- RTOS:时间片用完了赶紧腾地方,到时间我要赶人了!
如果一个协议要求在几十个、甚至只有几个时钟周期之内完成一连串 IO 操作,那么常规的“软件模拟”最后很容易变成“主核在一段时间里什么别的事情都不能做,专门伺候 GPIO”:
- 主核:忙着呢,谁都别烦我!(关中断)
- 中断:喂!开门!你给我出来!
- 主核:(听不见)
- (处理完 GPIO 操作后)主核:谁叫我?
- 中断:黄花菜都凉了。
这正是 PIO 和 PIOC 都试图解决的问题:把原本需要主核逐周期执行的 IO 行为,交给一个可以独立运行、时序更加确定的可编程执行单元。当位级别的 IO 事务被下沉之后,主核负责的事情,就从“拉高-等-读-如果是 1 就跳到xx-等-…”变成了更加抽象的“执行一次某 IO 事务”。至于事务内部的几十个甚至几百个周期里究竟发生了什么、如何处理,主核不关心,交由那个执行单元自行完成。
到这里,我们反而可以暂时把两者的内部结构放到一边,来对比传统固定功能外设和 Programmable I/O 最终给使用者提供了什么。不过在这之前,我们先来同步一下:前者的共同点是功能在芯片设计阶段就被硬件电路固定下来,此后用户只能按既定的方式使用它,所以本文称之为硬固化外设,UART、SPI、I2C 都属于这一类;与它相对的则是可编程 IO,也就是 PIO 和 PIOC 这类要由用户自己写程序才能确定功能的组件。
- 硬固化外设:
- 芯片设计工程师定义 UART / SPI / I2C 的硬件电路
- 用户按约束使用
- 可编程 IO:
- 芯片设计工程师提供可编程 IO 执行环境
- 用户编写程序得到自己需要的数字接口
- 用户按自己定义的约束使用
这才是 PIO 和 PIOC 最重要的共同点。它们被放在一起讨论,并不是因为“都叫 PIO”,也不只是因为都能实现多种多样的协议,而是因为它们都把原本固定在芯片设计阶段的部分 IO 行为,交给了用户在芯片出厂之后通过软件重新定义。只不过,在用什么硬件来实现这一点上,两者给出了完全不同的答案:一边是一组专用的 IO 状态机,另一边是一颗为 IO 控制高度特化的微型 CPU。
而这也正好解释了为什么“用 PIOC 来实现 SWD”的例子能够成立。我们并不需要 PIOC “认识” SWD,它同样不认识 UART、I2C、1-Wire,它只需要认识自己的指令、GPIO 和时序。而剩下的事情,就是程序本身。而且不止 SWD 如此,PIOC 这类 Programmable I/O 最有意思的地方,可能恰恰不是“它支持多少种协议”,而是(在 PIOC 资源和时序满足的条件下)只要能把一个数字接口描述成一段它能够执行的程序,这个接口就有机会成为一个 PIOC 外设。
可能有读者会困惑:PIOC 只有 2 个 GPIO 可用,一个甚至没有独立 RAM 的 CPU,和一套甚至有点简陋的指令集,它究竟凭什么完成这些事情?
04 两根 GPIO,到底能干什么?
04.1 数字接口需要什么
要回答这个问题,不妨先做一件有点反常识的事:现在让我们先忘掉我们所熟知的 UART、I2C、1-Wire 等协议,然后来看这段波形:
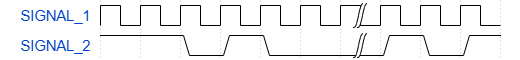
当看到这样的波形的时候,我们会说“这应该是某种数字接口的波形”。但是为什么我们会说“数字接口”呢?
重新来审视我们的判断过程,会发现首先提取到的特征是有两条信号线,且每条信号线都只有 2 种电平,大部分时刻都处于其中一种电平的稳态,有时会在高低电平之间切换。SIGNAL_1 呈现出周期性、等间隔的高低电平切换的特征,而 SIGNAL_2 不是每次都和 SIGNAL_1 一起切换电平。在 SIGNAL_1 由高电平切换到低电平(下降沿)时,SIGNAL_2 总是保持不变,此时电平稳定而可以被采样。
回顾一遍,会发现我们的描述全都是“电平”、“跳变”、“保持”、“间隔”这一类关于信号本身行为的词,没有一个是关于“这是什么协议所以如何如何”的,但是这会让我们产生“这应该是某种数字接口”的判断。也就是说,我们判断它是数字接口,实际上是以一系列信号行为为线索的。而这些信号行为可以再分解为一组很小的“原语”,最常见的包括:
- IO 操作类:
- 输出一个电平
- 采样一个电平
- 切换 IO 方向
- 控制类:
- 等待若干周期
- 判断一个条件
- 分支到下一个状态
看起来就这么一点,但一个数字接口的全部行为正是通过按不同的参数、序列组织这些原语来实现的。我们平时说的 UART、I2C、1-Wire,其实只是这些原语的不同参数组合与不同排列顺序。而这些参数与顺序,恰恰就是协议文档里那些看上去琐碎的条款所规定的东西:波特率是多少,空闲电平是高还是低,采样落在时钟的哪个边沿,拉低数据线之后要等几个周期才允许对方回应,收到什么之后才进入下一状态。至于协议叫什么名字,反而是这里面最不重要的一项。也就是说,一个数字接口对执行环境提出的要求其实少得出奇:几个可独立驱动、采样的 IO,一套足够精确且可预测的时间基准,以及能够根据输入状态做简单判断和跳转的执行能力。至于这些能力具体由什么硬件实现,协议本身通常并不关心。
那么,两根 GPIO 能覆盖什么?比如说,需要 4 条并行数据线的接口 QSPI,它确实做不了;不过只用 1-2 条信号线而把复杂度全部推给时序的接口,其种类数量比想象中要多。有些数字接口并不需要很多线,它们只是把原本应该由更多硬件资源承担的复杂度,转移到了时间轴上。
04.2 PIOC 和 GPIO Bit-bang 的分界线
一些读者在读上一篇使用 PIOC 实现 DS18B20 温度读取的时候其实已经产生了这样的疑惑:我们写的 PIOC 汇编,不还是“写电平-等-读电平-判断-跳转”这一套东西吗?把这些东西从主核丢给 PIOC 之后,波形还是那样,协议通信原语也还是那样。这和换了个地方 bit-bang 有什么区别?
倒也没错,从指令序列的角度来看,这个说法甚至无法反驳,PIOC 程序理所当然地是一段 bit-bang:它要产生的就是同一个波形,依据的又是同一套原语。这里实际上改变的是“谁在执行这些操作”。
主核亲自执行代码来实现 bit-bang 的时候,主核自己的控制流、执行的指令序列就是时序的一部分。在这种情况下,每条指令都既是逻辑也是时序,执行到哪一条指令,波形就走到哪一步。因此,“主核在干什么”就会直接体现在波形里,不仅仅包括想要产生的波形时序,还有主核在处理其他事务时对时序的影响,甚至还有主核为了优先处理时序而对其他事务造成的影响。前文中“主核三头六臂”的荒诞一幕,正是主核执行 bit-bang 代码生成波形时被迫和这些事情交错在一起的无奈境况。
而把实现时序的代码交给 PIOC 之后,波形不再从主核的指令流中产生,主核更不必关心每一个 bit 的产生过程。它只需要启动这一段 PIOC 程序,并在完成之后取得结果。至于这段时间主核正在处理什么,已经不再属于这段 IO 时序本身的一部分,PIOC 不关心。
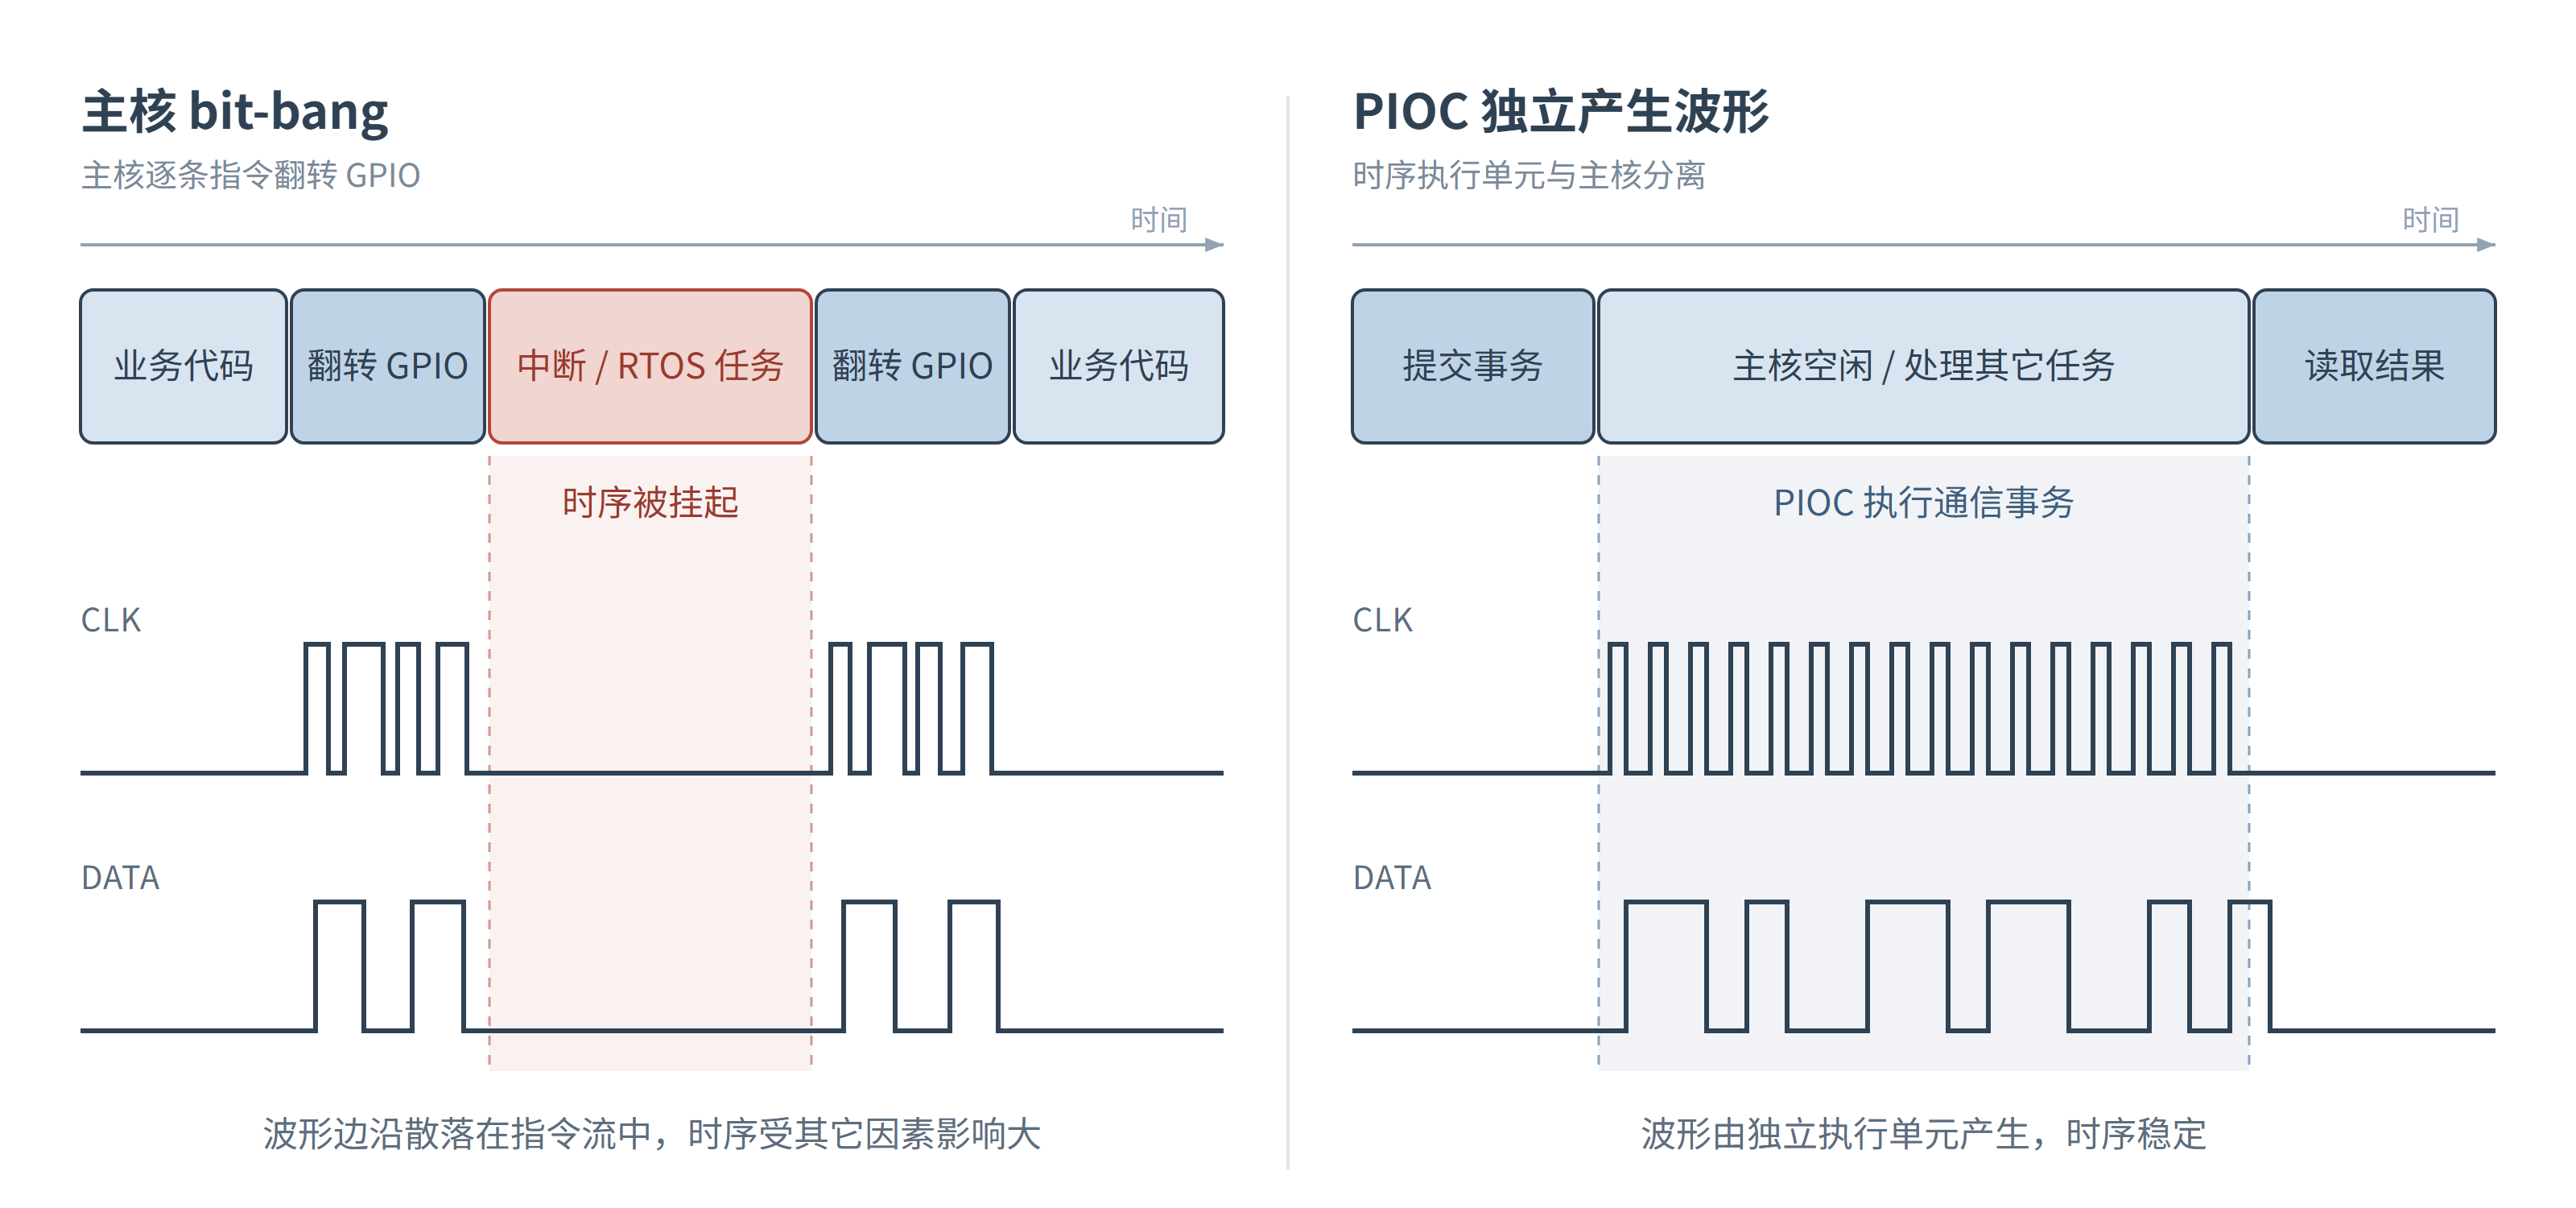
然而,分界线并不在“是否通过软件操纵 GPIO”上,很明显两边的波形都出自软件之手。尽管主核中的 bit-bang 代码同样可以被精心设计成严格的时序程序,但它仍然属于主核执行流的一部分。它占用的是主核的执行时间,主核在处理其它任务时,也必须仔细考虑这些任务是否会打断或影响这段时序。而 PIOC 程序是一个独立的组件,主核与它之间可以通过一组明确的命令、数据和状态接口交互。这种情况下,软件定义的仍然是同一套 IO 行为,但是它从主核的执行流中被剥离了出来,PIOC 则让这段软件获得了一个独立的执行环境,从而可以避免在主核指令流里的“拼车”执行。
不过很容易注意到的一个分界线是:这段操纵 GPIO 的程序,是嵌在主核的执行流里,还是运行在一个独立的执行单元里?前者是典型的主核实现的 bit-bang,后者则进入了“可编程 IO 组件”的范畴。不过这个组件的具体实现究竟是 CH32 片上的 PIOC、RP2040 的 PIO,甚至是由主 MCU 控制的另一颗专用于协议的 MCU,则是另一个层次的问题。
PIOC 并不需要理解“协议”这个概念本身,它只需要执行前面列出的这些基本操作。一段 PIOC 程序并不因为“实现了 I2C”才算数,它只是用这几个原语描述了一段符合 I2C 要求的时序。更进一步来想,既然执行单元依赖的只是这些与协议无关的、抽象的原语,那么在设计芯片的时候,也就没有必要预先知道它将来会去实现什么。
“只要把面粉、牛奶、鸡蛋、黄油什么的都准备好……”
05 PIOC 原来真的可以自己“烤”外设
05.1 聚焦于 SWD_Transfer
有读者应该觉得我废话太多了:“快点端上来罢!已经等不及了!”
的确,前面从理论上讲了这么多,饼也画得够大了,那么不妨就从我们前文选定的 SWD 协议出发,直接开工。我们要做的事情是:把 CMSIS-DAP 中的 SWD_Transfer() 这段软件模拟实现的 IO 时序程序,移植到 PIOC 上去执行。
首先看 CMSIS-DAP 中 SWD_Transfer() 的实现流程:(这里省略了一些具体细节,只保留了最主要的部分)
1 |
|
以上代码中,可以很明显看到一次 SWD_Transfer 事务包含了几个阶段:
- 请求阶段(Packet Request)
- 换向阶段(Turnaround)
- 确认阶段(Acknowledge)
- ACK 后进入数据阶段(Data)
- 读/写数据阶段(Read/Write Data)
- 空闲阶段(Idle)
- WAIT/FAULT 后进入假数据阶段(Dummy Data)
- 协议错误后进入恢复阶段(Back off)
- ACK 后进入数据阶段(Data)
也就是说,SWD_Transfer() 事务是先发“请求头”,根据从机的响应来决定进入哪种阶段处理。这恰好可以被转写成一个可执行的时序程序,交给 PIOC 来执行,也就是整个 SWD_Transfer() 都放进 PIOC 中。SWD 不同于 UART、I2C 等协议,它的状态机稍为复杂一些,在 SWD_Transfer 事务中需要做的事情也比较多,将整个事务交给 PIOC 执行可以大大减轻主核的负担。
在请求阶段,一个 Packet Request 包含 8 个 bit,分别是 Start、APnDP、RnW、A2、A3、Parity、Stop 和 Park。这其中 Start、Stop 和 Park 是固定的,Parity 是根据 APnDP、RnW、A2、A3 计算出来的,而 APnDP、RnW、A2、A3 又是来自传入的参数 request。因此,在请求阶段只需要使用到 request 这个参数。
在换向阶段,主机(通常是调试桥一侧)将 SWDIO 线从输出切换到输入,从机此时获得总线控制权。为了给主从机交接总线控制权留下足够的余量,这个阶段主机不驱动 SWDIO,仅发送数个周期的 SWCLK,具体数量与 DAP 配置中的 turnaround 参数有关。
在确认阶段,从机驱动总线,主机读取由 3 个 bit 组成的响应,有三种定义的响应结果:OK、WAIT 和 FAULT,其余的情况均视为协议错误。OK 表示从机已经准备好进行数据传输,主机可以进入数据阶段;WAIT 表示从机暂时无法处理请求,主机需要等待一段时间后重试;FAULT 表示从机发生了错误,主机需要进行错误处理。
如果确认阶段的响应是 OK,主机将进入数据阶段。数据阶段的行为取决于请求阶段的 RnW 位:如果 RnW 为 1,主机会向从机读取 32 位数据和 1 位奇偶校验位,然后完成一次换向;如果 RnW 为 0,主机会先完成一次换向,然后向从机写入 32 位数据和 1 位奇偶校验位。在读写阶段完成后,如果传入的参数要求捕获时间戳,主机将读取时间戳寄存器的值;如果传入的参数要求空闲周期,主机将发送若干个空闲周期。如果确认阶段的响应是 WAIT 或 FAULT,主机将进入假数据阶段,完成 33 个假数据位+换向的过程。如果确认阶段的响应是协议错误,主机将进入恢复阶段,完成 33 个恢复位+换向的过程。
05.2 设计 PIOC 的命令和数据接口
如果我们把原本运行在主核上的 SWD_Transfer() 搬到了 PIOC,那么原来函数调用时可以直接访问的参数,就需要通过某种方式显式交给 PIOC。反过来,PIOC 执行完成后,也需要把 ACK、读数据等结果交还给主核。
就像前两篇文章中提到的那样,为了在主核和 PIOC 之间传递命令、交换数据,我们需要定义一组 SFR 来作为主核和 PIOC 之间的接口。主核通过写入这些 SFR 来传递命令码和数据,PIOC 执行完事务后再通过这些 SFR 返回结果码和数据。必要时,PIOC 还可以通过中断来通知主核。
上一节的分析中已经指出,此函数需要的信息包括:
- Packet Request 的参数 request
- 数据阶段的读写数据 data
- SWD 配置中的 turnaround、idle_cycle、data_phase 参数
- 时钟配置中的 SWD 延时参数
这些信息都是调用 SWD_Transfer() 时传入函数现场的,在原来主核代码的 C 实现里:request 和 data 是函数参数,turnaround、idle_cycle、data_phase 是全局变量 DAP_Data 里的成员,延时参数则由设置时钟的函数计算并存入 DAP_Data。由于该函数与主核共享同一套寄存器和同一块内存,这些信息在主核中根本不需要有意识地传递。
然而,CPU 函数调用可以直接访问函数参数和全局变量,因为它们共享 CPU 的地址空间;但对 PIOC 来说,情况有些不同,它在 CH32 MCU 中的地位是总线上的外设,一旦把函数从主核执行流中剥离出来,原来隐含在函数调用约定中的参数,就必须显式变成两个执行单元之间的接口。因此需要通过两边唯一能共同访问的 PIOC SFR 来传递必要的信息,所以我们必须显式定义 CPU 与 PIOC 之间的接口。
所以,要让主核“调用”PIOC,就只能把参数写进 SFR,再等 PIOC 把结果写回另一个 SFR。这也就意味着,为了保持充分的解耦合,我们得先给这个还不存在的“SWD 外设”设计一套寄存器接口。一般,这样的接口包括“命令”、“结果”、“控制信号”、“参数”、“数据”等,例如,可以如下设计:
| 主核侧符号 | PIOC 侧别名 | 用途 |
|---|---|---|
R8_CTRL_WR |
PIOC_CMD_CODE |
命令:命令码(兼任启动信号,写入即启动) |
R8_CTRL_RD |
PIOC_CMD_RESP |
结果:结果码(兼任完成信号) |
R8_DATA_REG0 |
DAP_TURN_CYCLE |
参数:换向周期数 |
R8_DATA_REG1 |
DAP_IDLE_CYCLE |
参数:空闲周期数 |
R8_DATA_REG2 |
DAP_DATA_PHASE |
参数:数据阶段标识 |
R8_DATA_REG3 |
DAP_CMD_ARGV |
参数:本次事务的参数 request,原样透传 |
R8_DATA_REG4 |
DAP_FAST_CFG |
参数:快路径开关与跳过周期数 |
R8_DATA_REG5 |
— | 未使用 |
R8_DATA_REG6 |
DAP_DELAY_CYC_D0 |
参数:常规路径延时参数 D0 |
R8_DATA_REG7 |
DAP_DELAY_CYC_D1 |
参数:常规路径延时参数 D1 |
R32_DATA_REG16_19 |
DAP_DATA_D0 ~ D3 |
数据:32 位需要读写的数据 |
首先,表格里最不能少的是 R8_CTRL_WR 和 R8_CTRL_RD 这一对,它们不仅传递值,还隐含了“这一值有没有被对方消费”的同步语义。它们不是普通的数据寄存器,因为它们是“一侧读写、另一侧只读”的,并且一侧写入和另一侧读取都有独立的状态位指示,这使得它更像一对双向邮箱。主核需要给 PIOC 下命令时,写一次 R8_CTRL_WR,RB_DATA_MW_SR 状态置 1,直到 PIOC 读一次 R8_CTRL_WR 后被清 0。相应地,PIOC 需要向主核返回结果时,写一次 R8_CTRL_RD,RB_DATA_SW_MR 状态置 1,直到主核读一次 R8_CTRL_RD 后被清 0。这对于确认“另一侧是否已经读了寄存器”来说相当方便。
回到本文所基于的这个 DAP 调试桥案例,命令码本身就可以直接写进 R8_CTRL_WR。这样一来,“告诉 PIOC 做什么”和“让 PIOC 开始做”就是同一个动作,不需要额外准备一个信号寄存器,也不需要先写命令、再发信号两步。由此,可以编写以下函数便于主核调用 PIOC:
1 | void PIOC_DAP_RunCmd(PIOC_DAPCmdType_t cmd, uint8_t cmd_arg) |
这样,主核调用 PIOC 执行 SWD_Transfer 事务的过程大概就像这样:
1 | // 写事务需要先准备数据 |
而 PIOC 一侧则是相反的顺序:
1 | WAITB WB_DATA_MW_SR_1 ; 等主核写:等待 RB_DATA_MW_SR 置 |
此时主核交给 PIOC 的并不是一份已经“预编译”的 SWD 波形,而是和原来调用 SWD_Transfer() 时一样的参数。PIOC 会自己完成后面的请求头、ACK、数据、换向和校验等时序。(大厨现炒,不卖预制菜(划掉))
由于本文中只涉及将 SWD_Transfer 事务交给 PIOC 处理,目前只有一个命令码 PIOC_DAP_SWDTRANSFER(0x01)。PIOC 平时停在一条等“主机已写”标志的指令上,退出等待后读取命令码,再分发到对应的处理程序:
1 | PIOC_INIT_1: WAITB WB_DATA_MW_SR_1 ; 等主核写命令 |
请求阶段的实现在 PIOC 里大致就是这个样子:
1 | ; 请求阶段:逐位送出请求头,同时累加校验 |
容易看出这里有明显的重复式代码片段,这就是 C 版本里 SW_WRITE_BIT 宏展开后的结果:先把 SWDIO 置成这一位该有的电平,再给出一个 SWCLK 周期。对照 05.1 里的宏定义,两者的动作序列是一致的,DELAY_L2 对应的正是那个 PIN_DELAY(),此时 SWCLK 由 PIOC 自己产生,主核不参与。
一些位的发送过程中掺入了 BTSC 指令,其含义是“测试 SFR 的某一位,为 0 则跳过下一条指令”,所以 INC 只在被测试的那一位为 1 时执行,SFR_INDIR_ADDR 在这里被临时当作校验位的累加器,实现的其实就是 C 版本中的 parity += bit 功能。
当然,parity 完全可以由主核提前计算,而在当前实现中把它留给 PIOC 来处理主要是为了让 PIOC 程序真正承担完整的 SWD_Transfer() 底层逻辑,而不是只负责无脑复制主核已经准备好的结果。这里的重点并不是 parity 本身,而是这个例子说明了:PIOC 接收的是“事务参数”,而不是像普通外设模拟时的“事务波形”。
32 位数据则通过 R32_DATA_REG16_19 在两侧交换。对于写事务,主核在启动 PIOC 之前把数据写进去;对于读事务,PIOC 完成读取后再把数据写回。SWD 本身采用 LSB first,而这里的 D0 也是最低字节,因此无需额外进行字节重排。
至于 turnaround、idle cycle、data phase 以及 SWCLK 延时等参数,它们不会随着每一个 SWD_Transfer() 改变,因此在处理相应的 DAP 配置命令时写入 PIOC 的 SFR,只要确保事务发起之前已经正确配置过即可。一次事务前后完全不用碰它们,这一点和用普通外设的习惯是一样的:工作模式不会每传一个字节就重新配置一次。快路径的开关和跳过周期数也属于和 SWCLK 延时同一性质的配置,只不过这是第六章的内容,就不过多剧透。
把上面的东西串起来,一次 SWD_Transfer() 在接口这一层就是下面这样的过程:
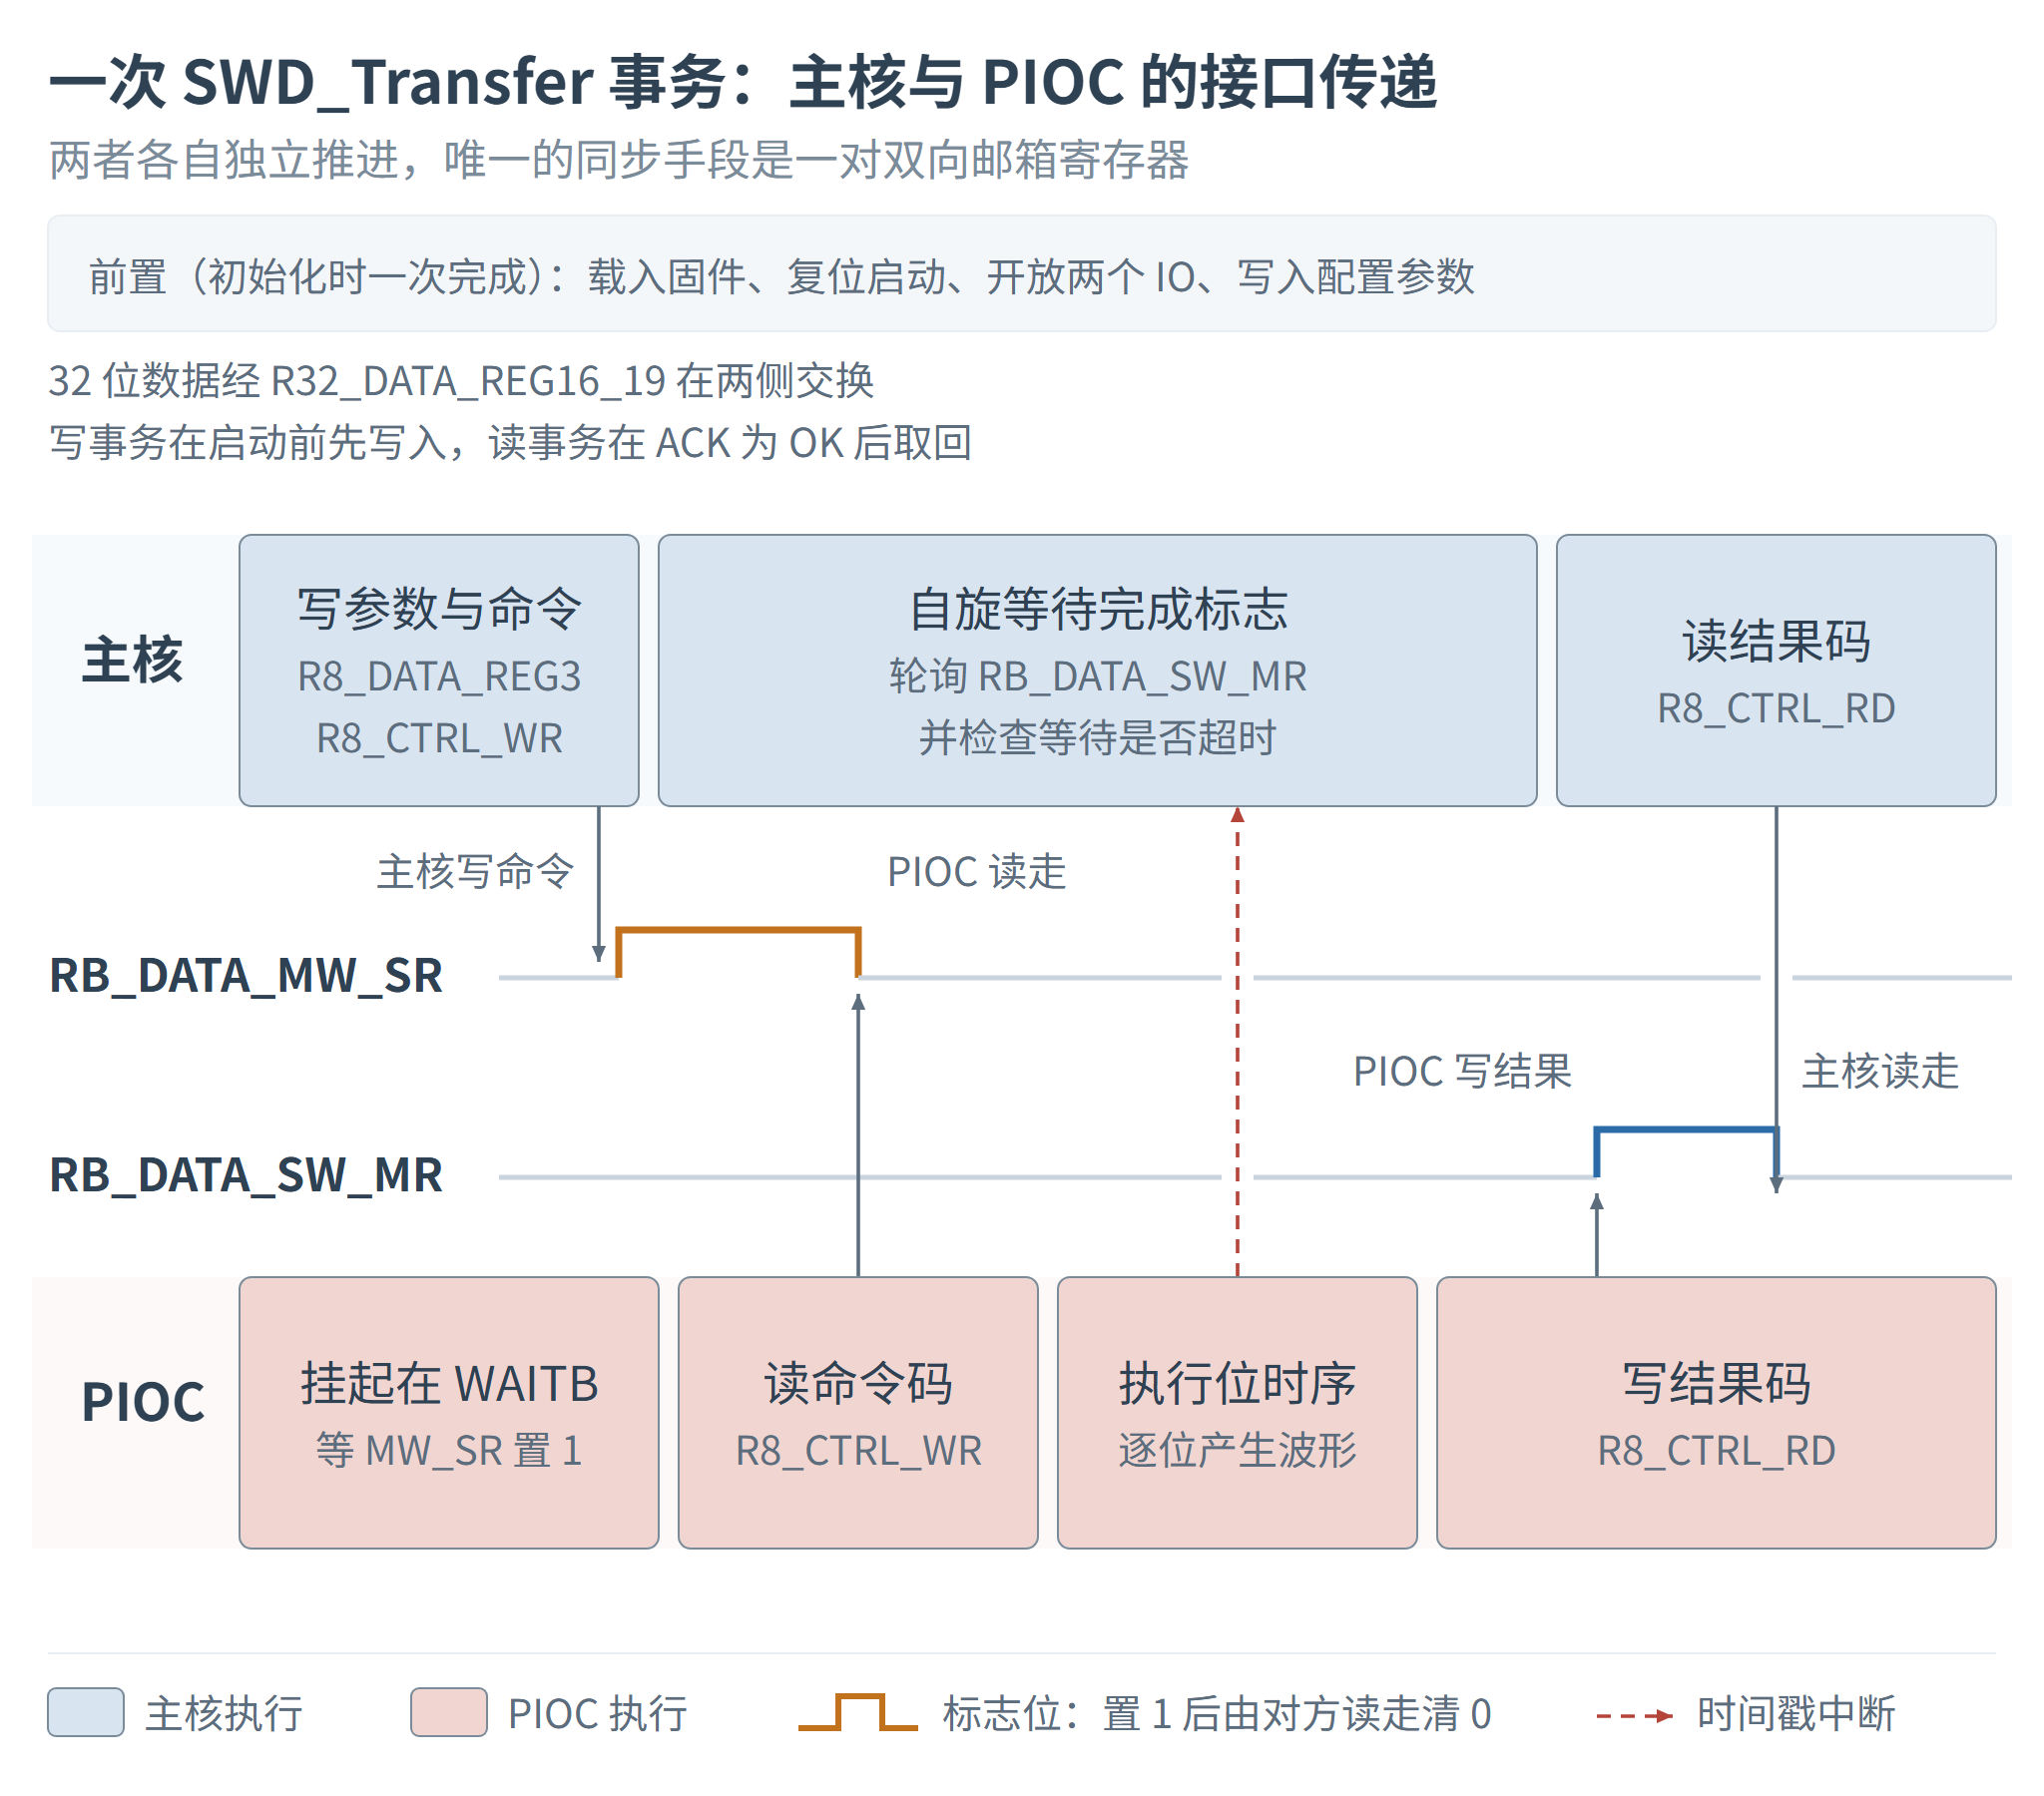
整个过程里,主核做的事情就是“填寄存器、写命令、等状态位、读结果”,它在 SWD_Transfer 事务中完全不需要关注 SWDIO 和 SWCLK。
这时我们可能会发现一些熟悉的行为模式:
- 初始化配置参数(换向周期、空闲周期、延时、快路径配置)
- 写数据寄存器
- 发起传输并轮询完成
- 读数据寄存器
- (如果发生错误)处理错误并恢复
05.3 主 CPU 与 PIOC 的边界
接口规划好以后,这一节回到主核这一侧,看看一次 SWD_Transfer() 中,哪些工作已经被移出主核,哪些工作仍然必须由主核承担,不仅限于代码放在哪里执行,还包括执行权、IO 所有权以及异常恢复的边界。
先看把 SWD_Transfer 事务交给 PIOC 后,这个函数的实现(这里省掉了与原实现完全一致的部分细节):
1 | uint8_t SWD_Transfer(uint32_t request, uint32_t *data) |
“我的 bit-bang 呢?那么长一段 bit-bang,怎么没了?”
哎,还就是没了。
严格来说,它并没有消失,只是从主核的执行流里消失了。
整个函数里没有一行控制 GPIO 产生时序的代码,连 SWDIO 的输入/输出方向切换也是由 PIOC 在内部控制。主核在这个函数里只需要把引脚转交给 PIOC、写参数、启动、等结果、收回引脚。
那么“启动”和“等结果”具体是怎么完成的?上文已经提到,主核与 PIOC 之间有两个方向相反的状态位,主核写一次 SFR_CTRL_WR(写动作自动置 1 “主机已写”标志);PIOC 平时正停在一条等待这个标志的指令上(WAITB),等待退出条件满足后就读 SFR_CTRL_WR(读动作自动清 0),然后开始执行整条 SWD_Transfer() 的时序。事务执行完毕后,PIOC 把结果码写入 SFR_CTRL_RD(写动作自动置 1 “从机已写”标志),然后等待主机读取后此标志被清 0。本文中的例子里,主核在 while 循环里等这个响应标志,等到之后读 SFR_CTRL_RD 取状态码(读动作自动清 0),若为读事务时再读一次 32 位数据寄存器,PIOC 在主机读取 SFR_CTRL_RD 后回到等待命令的状态。
在这个函数中,主核甚至几乎没有做任何与 PIOC 程序本身有关的事情。本文的例子中,PIOC 的固件在初始化时被主核复制到 PIOC 复用的 RAM 区域,此后不需要每次重载。主核每次发起命令时,只是在操作一个已经处于就绪状态的组件,这就不是在“调用一个子程序”的层面了。
一些参数相当于“全局配置”的性质,不需要每次事务都改变,例如换向周期数、空闲周期数、数据阶段标识等,因此可以在主核在处理 DAP 的配置命令时(如 DAP_SWD_Configure 等)顺手写进对应 SFR;SWCLK 的延时参数同样是在设置 SWJ 时钟时由主核顺手算出来写入 SFR 的。这一点和用普通外设的习惯是一样的,不需要每次都重新配置。
本文的例子基于 CH32V205 实现,故选择 PB10 作为 SWDIO、PB11 作为 SWCLK。由于只将 SWD_Transfer 事务交由 PIOC 处理,因此其它基于 GPIO 模拟的通信原语(SWJ 线路复位、JTAG 到 SWD 的切换序列等)仍然需要由主核实现。为此,在初始化阶段,PIOC_DAP_Init() 会向 PIOC 载入固件、复位并启动 PIOC、允许 PIOC 使用其连接的两个 IO,并提前把 PB10/PB11 的复用号选择到 PIOC,但保持引脚的模式为普通 GPIO 推挽输出,以供默认状态下主核使用。
因此,每次事务前后都需要交接 PB10/PB11 的控制权:事务开始前,主核把 PB10/PB11 改成复用推挽,控制权交给 PIOC;事务结束后再改回普通推挽输出,控制权收回。这是外设和主核共用同一对引脚所必须做的,因为 PIOC 的固件和主核的 bit-bang 实现需要轮流控制这两根线。
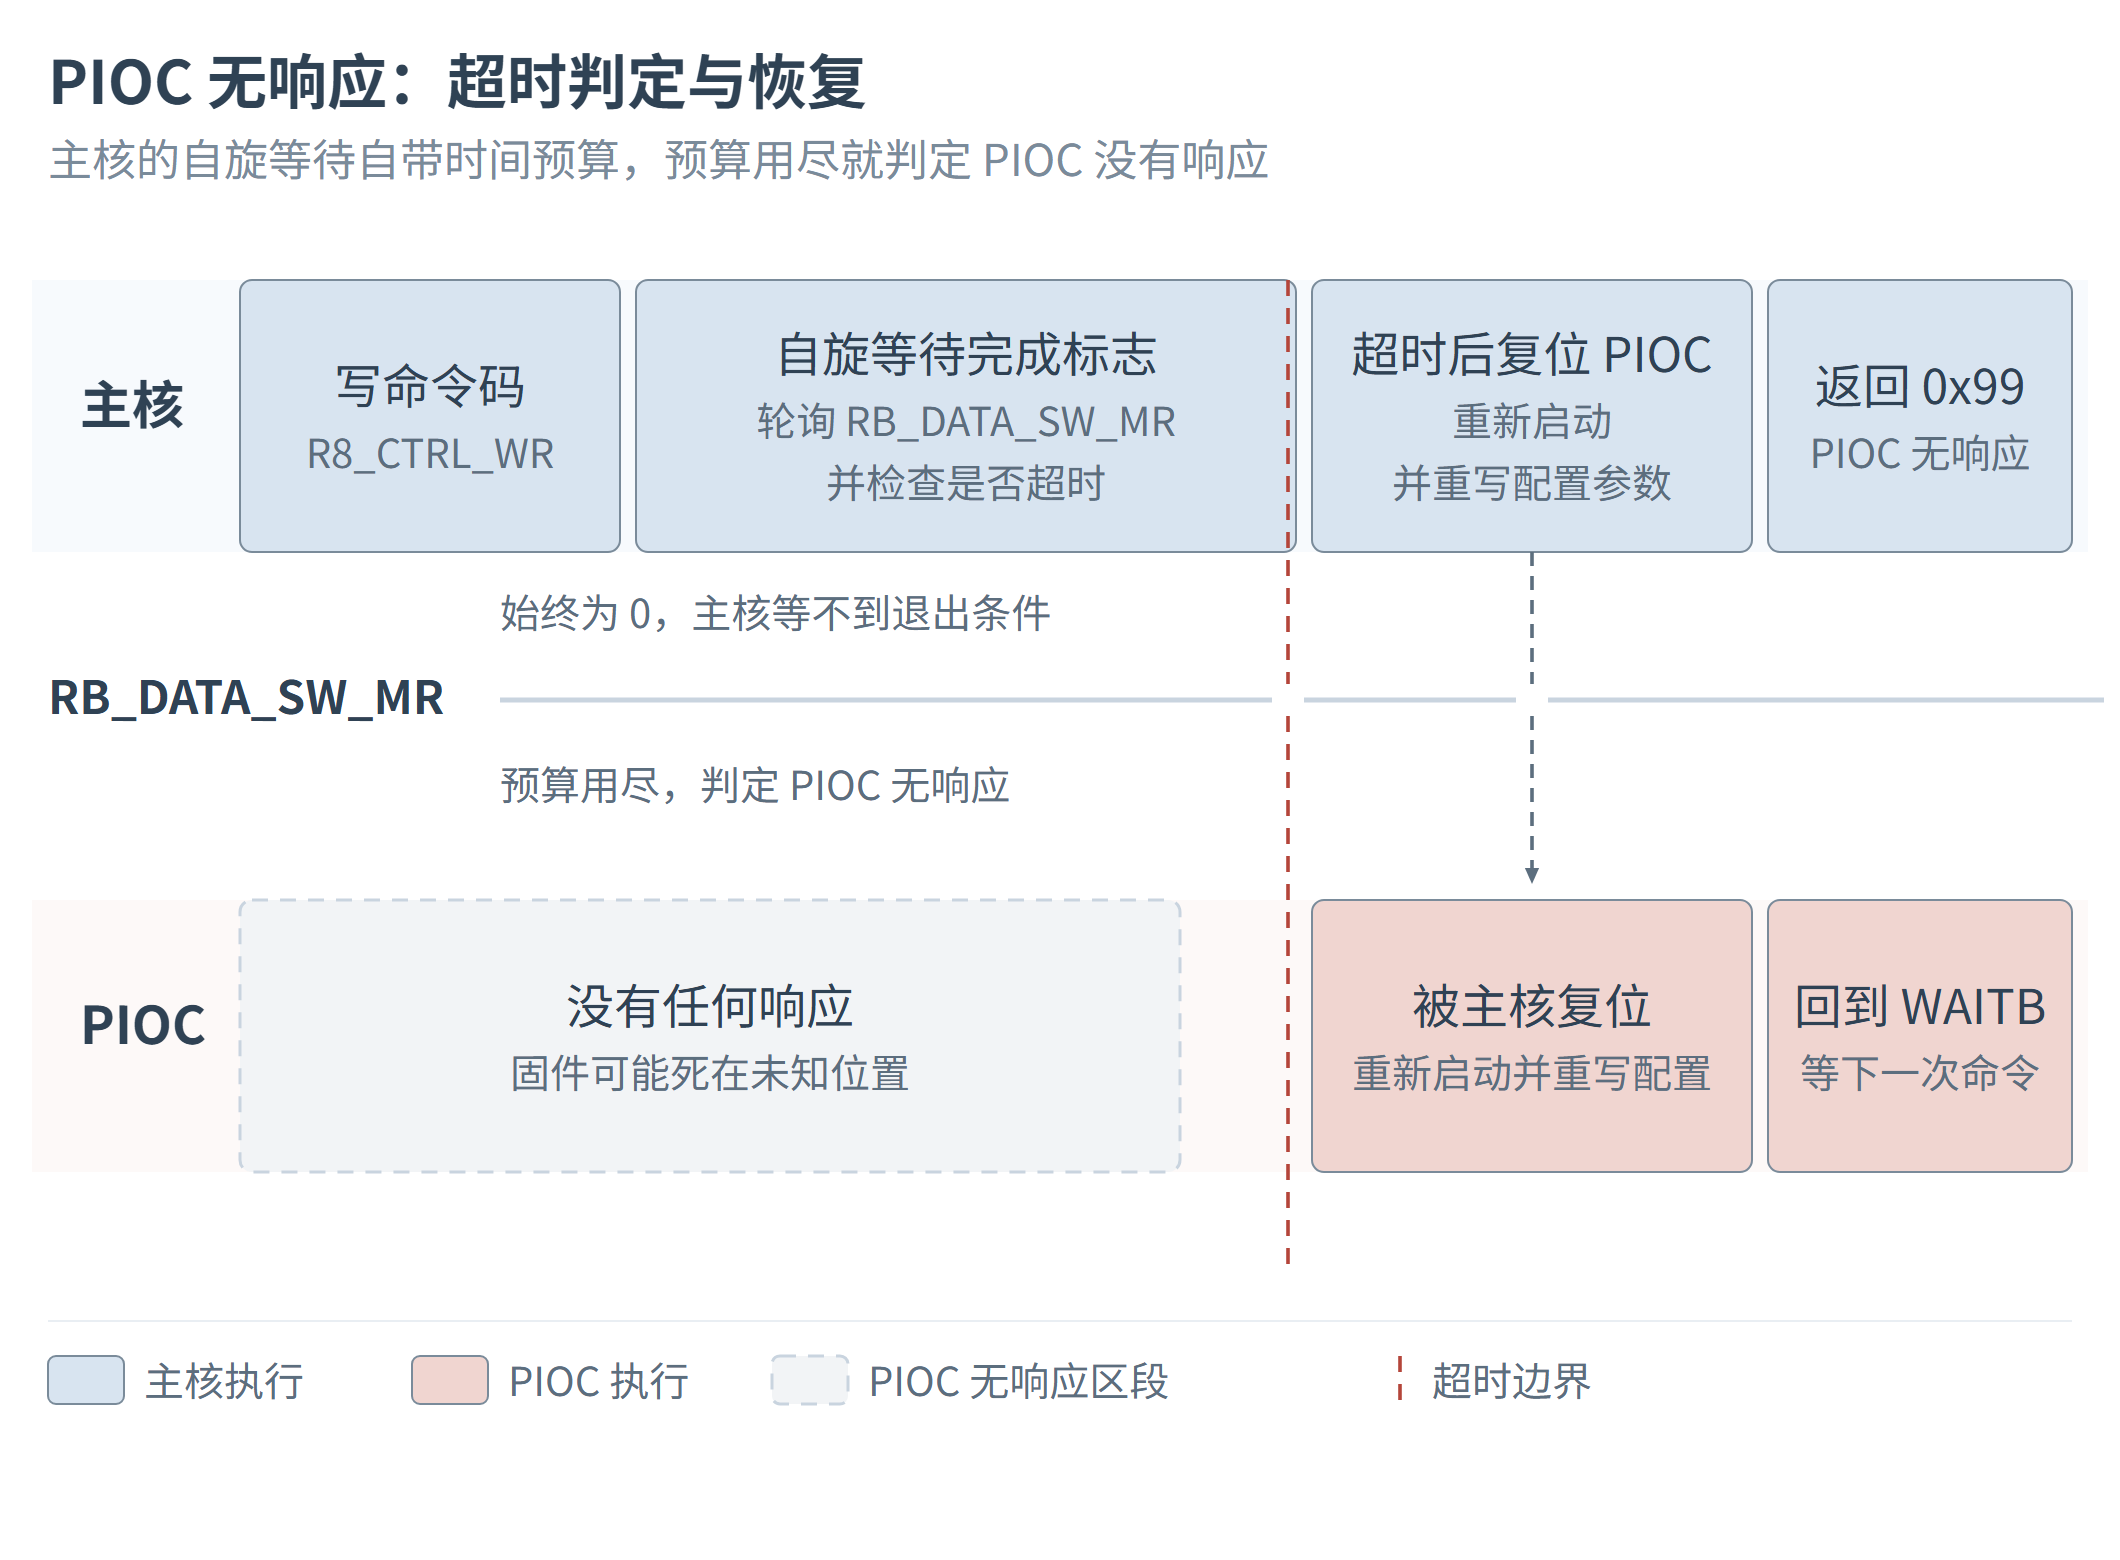
从演示例子的角度来说,主核当然像上一篇中那样自旋等待 PIOC 的响应标志,但这一篇我们稍微“正式”一点,加入像 I2C 使用中那样的超时机制。由于 PIOC 跑的是一段我们自己写的固件,写错了就可能死在不知道哪里,所以自旋等待中会检查 PIOC 执行是否超过了预定的超时时间,若超时则判定 PIOC 在预定时间内未完成(可以视为执行异常或 PIOC 无响应),重新执行加载固件之外的全部操作并返回一个自定义的非标错误码(0x99)。这个错误码的含义是“PIOC 没有响应”,对于调试可以起到帮助。
在这个实现里,我们用中断整了一点“花活”。CMSIS-DAP 中定义了可选的测试域计时器(Test Domain Timer),可以要求在对应的事务中返回调试桥一侧的时间戳。Arm 的参考实现中,默认直接使用了 Cortex-M 内核集成的 DWT 提供计数值。但对 PIOC 来说,显然没有这样一个方便的时间基准。因此这里采用了一个“借资源”的办法:当 PIOC 执行到需要记录时间戳的阶段时,发起一次中断请求,由主核来打这个时间戳。这也正说明“严格 IO 时序”和“系统级时间信息”并不一定必须属于同一个执行单元。
也就是说,现在的情况变成了:
| 主核负责的 | PIOC 负责的 |
|---|---|
| USB/DAP 业务 | SWD 位级时序 |
| 请求缓存 | request/ACK/data |
| 配置参数计算 | 严格时序执行 |
| GPIO 所有权管理 | SWDIO/SWCLK 实时控制 |
| 超时与恢复 | 事务执行 |
| system timestamp | 发起 timestamp IRQ |
有没有感觉主核这一侧看到的东西很熟悉?操作普通通信外设时好像也是这个套路。
到这里,一个能用 PIOC 跑起来的 SWD_Transfer() 实现就算完成了。它现在的工作方式还很朴素:用普通的延时子程序凑出 SWCLK 的周期,跑起来了,能用,但是当尝试加速 SWCLK 时又会遇到另一个新的问题。
06 当踢到 8MHz 的铁板
06.1 普通延时函数已经不够用了
上一章中,我们提到了 PIN_DELAY() 这个宏,它的作用是产生一个 SWCLK 周期的延时。在 PIOC 程序中,它的功能由 CALL DELAY_L2 来实现。它的实现如下:
1 | ; ================ |
根据上面的注释,DELAY_L2 的延时周期组成如下:
CALL指令:2 个周期RET指令:2 个周期- 延时参数传入方式:
- DAP_DELAY_CYC_D1:循环计数器 D1,每次循环消耗 768 个周期
- DAP_DELAY_CYC_D0:循环计数器 D0,每次循环消耗 3 个周期
- 延时周期计算公式(D0>0):
- D1 > 0 时:768 * D1 + 3 * D0 + 7
- D1 = 0 时:3 * D0 + 8
让我们考虑两个极端情况:极大和极小。当 D1=D0=255 时,一整次延时调用(含 CALL+RET)总共消耗 768*255 + 3*255 + 7 = 196612 个周期;当 D0=D1=0 时,经过逐指令计算总共消耗 10 个周期。也就是说,一次调用 DELAY_L2 到返回最短需要 10 个周期,最长需要 196612 个周期。每个 SWCLK 需要调用两次延时,按 CH32V205 上 PIOC 的主频为 192MHz 来非常粗略地估计 SWCLK,最低频率约 488Hz,最高频率约 7.68MHz。
对于一个调试桥来说,最低频率大概 488Hz 当然够用了,但最高频率 7.68MHz……对于主频 192MHz 的 CH32V205 来说,“怪怪的”。这说明我们目前的实现在功能上没问题,但是在效率上还有提升空间。
不妨分析一下 PIOC 汇编中每发送 1 位所消耗的周期组成:
1 | BP2F BO_PORT_OUT0,0 ; 1周期;写 BIT 到 SWDIO |
也许是巧合,非常有趣的一个现象是,BTSC + INC 这个组合无论被选中测试的位是 0 还是 1,合计都正好消耗 2 个周期,因此从周期预算角度看,每个位的逻辑部分实际上是固定的 5 周期,这消除了奇偶校验位计算产生的时序抖动,有利于时序分析。
也就是一般情况下,发送 1 位消耗 2n+5 个周期,其中 n 是一次完整的 CALL DELAY_L2 从调用到返回所消耗的周期数,包含 CALL 和 RET 的开销。当 n=10 时,每发送 1 位消耗 25 个周期,折合 SWCLK 的频率约为 7.68MHz,与我们推算的一致。很明显 2n+5(n≥10) 这个公式里,2n 一项总是占主要的部分,这说明在当前实现中,即使已经把 DELAY_L2 压到了最短的 10 个周期,两次延时仍然贡献了整个位周期的 20 个周期,而真正用于 GPIO 操作、数据判断和校验累加的指令只占了 5 个周期。在当前可达的最短常规延时下达到 7.68MHz 时,位周期的主要部分仍然由两个 DELAY_L2 占据。
换个角度,还是用极限法,考虑极端的情况:保持目前的实现结构不变,如果暂时把每次 DELAY_L2 的整个调用都理想化为一条内联的(这样至少把 CALL 和 RET 的开销省掉)单周期 NOP,那么这段程序每发送 1 位的理论最小开销是 7 个周期,对应约 27.4 MHz。这进一步验证了目前的瓶颈几乎是当前延时实现本身。
现在我们终于发现了到底什么“怪怪的”:明明在 PIOC 中大多数普通指令只需要 1 个周期,一个 192 MHz 的执行单元,仅仅因为一个“短延时函数”就把 SWCLK 卡在 7.68 MHz,这怎么看都不像它真正的能力边界。
也就是说,我们现在的问题已经不是“PIOC 算不过来”,而是“我们没有办法以足够低的开销制造出一个只有几个周期长的、可变的延时”。DELAY_L2 延时至少消耗 10 个周期,那么如果我们内联 10 个 NOP,其实也是 10 个周期:那为什么还要调用 DELAY_L2 呢?我们可能需要一个能在 1 到 10 周期之间以单周期为粒度,根据 SWCLK 目标频率动态变化的短延时。
不过 DELAY_L2 并不是一个失败的设计。对于几十、几百甚至数万周期的延时,循环显然比直接展开内联 NOP 更节省程序空间;但对于这里这种“只差几个周期”的短延时来说,反而“一个人吃火锅,锅底太贵了”(也就是最小开销太大)。
06.2 直接对程序计数器动手
我们现在遇到了一个有点奇怪的情况。PIOC 的普通指令大多只需要一个周期,理论上来说它应该也能够灵活可控地延迟 1 到 10 个周期。但我们写出来的 DELAY_L2 的整个调用过程最短也要消耗 10 个周期,而且最小可控粒度还是 3 周期(DECSZ+JMP),这就导致了一个奇怪的现象:“几乎单周期的指令集却不能实现单周期粒度的延时”。这很奇怪吧.jpg
但是这里我们可能产生了一点误解,问题不在于 PIOC 能不能产生这样的延迟,因为 PIOC 根本不知道这是不是延迟函数,NOP 和循环递减对它来说只是普通的指令,只是我们用一段执行结果不重要、消耗周期确定的子程序来“实现延时的效果”,也就是让程序在这段指令范围内消耗确定的 N 个周期。所以我们应该把目光从表面的“寻找可控短延时函数”上移开,考虑一下如何“消耗可变的周期”。这两个问题看起来很像,实际上完全不同。上一节极限法思考中把延时函数调用理想化为单条内联 NOP 能提供低至 1 个周期的延时,但是不能在运行时被轻松配置。而可以运行时配置延时周期的 DELAY_L2 之所以会受到这些限制,是因为我们选择了“子程序 + 循环”这种实现方式:
1 | DELAY_A: ; 入口 |
只要我们坚持这种实现方式,无论如何 CALL+RET 的开销是无法避免的,循环控制本身也会带来自己的最小粒度。可问题在于,SWCLK 需要的恰恰是几个周期这样非常短、而且由主核根据目标频率动态计算出来的延时。对于这种场景,继续抠 DELAY_L2 的开销已经有些南辕北辙了。
遇到棘手的问题,不妨列出以下要素开始分析:
- 需求:延迟函数的执行周期可控,且最小延时小于 10 个周期。
- 现状:
DELAY_L2的最小延时为 10 个周期。 - 困难:
CALL+RET的 4 周期开销无法避免,动态调节至少以 3 周期为单位(DECSZ+JMP)。 - 我们改不了的:PIOC 的指令集、PIOC 的执行单元、PIOC 的指令周期。
- 我们能改的:延迟的实现方法、所有 SFR,也就是说几乎所有出现在程序中的东西。
比如说,我们已经知道的 PIOC 可用的 SFR 表如下:
| 地址 | 名称 | 描述 |
|---|---|---|
| 00H | SFR_INDIR_PORT | 间接寻址的数据读写端口 |
| 01H | SFR_INDIR_PORT2 | 间接寻址 2 的数据读写端口 |
| 02H | SFR_PRG_COUNT | 程序计数器 PC 的低字节 |
| 03H | SFR_STATUS_REG | 状态寄存器 |
| 04H | SFR_INDIR_ADDR | 间接寻址的地址寄存器 |
| 05H | SFR_TMR0_COUNT | 定时器 0 的计数寄存器 |
| 06H | SFR_TIMER_CTRL | 定时器的控制寄存器 |
| 07H | SFR_TMR0_INIT | 定时器 0 的初值寄存器 |
| 08H | SFR_BIT_CYCLE | 编码位周期寄存器 |
| 09H | SFR_INDIR_ADDR2 | 间接寻址 2 的地址寄存器 |
| 0AH | SFR_PORT_DIR | 端口方向设置寄存器 |
| 0BH | SFR_PORT_IO | 端口输入输出寄存器 |
| 0CH | SFR_BIT_CONFIG | 编码位配置寄存器 |
| 1CH | SFR_SYS_CFG | 系统配置寄存器 |
| 1DH | SFR_CTRL_RD | eMCU读写且主机只读寄存器 |
| 1EH | SFR_CTRL_WR | 主机读写且eMCU 只读寄存器 |
| 1FH | SFR_DATA_EXCH | 数据交换寄存器 |
| 20H | SFR_DATA_REG0 | 数据寄存器 0 |
| 21H | SFR_DATA_REG1 | 数据寄存器 1 |
| … | … | … |
再回到上一节的极限法。当时我们把 DELAY_L2 的调用理想化成一条内联的 NOP,只是为了估一个理论下限。但这个理想化思考的结果却顺带暴露了一点:PIOC 并不关心什么是“延时”,它只关心指令;一段指令会消耗多少时间,就与这些指令各自周期的总和有关。一条内联的 NOP 是 1 个周期,两条就是 2 个,十条就是 10 个。于是“这一次要延时多久”这个问题,可以被改写成另一个问题:让程序这一次实际执行多少条指令。
但指令条数是编写时就写死在固件里的,而每次主核调用传进来的延时参数都可能不同。如果把所有可能的延时长度都展开写进程序,程序会臃肿得不成样子;而且不同长度之间还得靠一大堆控制流去挑,最后写出来的已经不是一个“可变延时”,而是一坨专门负责挑选延时的代码。
那么,运行时按需往固件里插几条 NOP,要几个周期就插几条,行不行?理论上来说,行,但动态插入的 NOP 会导致后面所有指令的地址都会平移,最直接的影响就是全部跳转目标都需要重定位。这无异于在运行时把汇编器和链接器再跑一遍,运行时重编译对于这个需求来说简直是意大利炮打蚊子。
既然“无中生有”很难做,那能不能“视而不见”?
我们真正需要的并不是“运行时修改程序”,而是“运行时选择执行路径”。也就是说,编写 PIOC 程序时,在延时位置内联 10 条 NOP,但是让程序在运行时只执行其中 N 条 NOP,从而达到“消耗 N 个周期”的效果。这样就可以在运行时动态控制延时长度,而且不需要修改固件本身。那么以请求阶段为例,我们考虑的快路径(FastPath)程序结构就是这样的:
1 | DAP_PACKREQ_FAST: |
那么,到底该让哪几条执行、哪几条被跳过?理论上来说,只看最终消耗几个周期,挑哪几条来执行都行,只要执行的数量对得上。但这是理论上,工程上每一种方案都是要付代价的。
我们真正希望的,是在这一段延时里只做一次尽可能简单的控制流操作。PIOC 的跳转本身就要比顺序执行多花 1 个周期,跳转越多,额外开销越大,能只跳一次就不要跳两次。因此被执行的那几条 NOP 最好连成一段,中间不插跳转。这样一来,要得到 1 到 10 之间任意长度的延时,控制流策略几乎只剩两种:
- 跳过前面 a 条,执行后面的 10-a 条;
- 执行前面 10-a 条,跳过后面的 a 条。
第二种排法要在一串 NOP 中间某处离开,必须有一条跳转指令把控制流送走;而跳转目标还要随着 a 变化,意味着 10 种长度就要在 10 个位置各准备一个出口,等于把同一个麻烦复制了 10 份。第一种排法则只需要一次控制流转移:让执行不从这一段的第一条开始,而是直接进入第 a+1 条,剩下的 NOP 就会一条接一条顺序走完,再自然连上延时之后的指令,NOP 中间一个出口都不需要。
两相比较,第一种显然更省事,它只需要处理一个问题:**从哪里开始执行这一段 NOP**。
1 | DAP_PACKREQ_FAST: |
需要额外的 3 个周期,就跳过前面的 7 条 NOP,从第 8 条开始执行;需要 7 个周期,就跳过前面的 3 条 NOP,从第 4 条开始执行;如果完全不需要额外的周期,就直接跳到后面的 BS 上。前面那几条根本没有被执行,但它们仍然待在固件里,指令码并不需要被修改。
然而翻遍指令集手册,只会发现有 BTSS、DECSZ 这些指令能跳过下一条指令,但是却没有“跳过下 k 条指令”的指令。代码里那个待定的位置,该怎么实现?
有一定微机原理基础的读者可能想到了一个方法:直接操纵程序计数器,改变执行流来改变程序的时序。
再看那张 SFR 表中间,夹着这么一行:
| 地址 | 名称 | 描述 |
|---|---|---|
| 02H | SFR_PRG_COUNT | 程序计数器 PC 的低字节 |
等等,这什么东西?堂堂程序计数器 PC 怎么就躲在一帮 SFR 里面?
那这就好办了,它既然是一个 SFR,那么操作 SFR 的所有方法都适用于它。
程序计数器 PC 指的是当前正在执行的指令的地址。只要写入 SFR_PRG_COUNT 会修改 PC 的低 8 位,下一步执行位置就会转移到由这个新 PC 决定的位置。那么假如我们要后跳 k 条的位置,只需要将 PC 的值加上 k 就行了。也就是说,上面的程序终于可以这样写:
1 | DAP_PACKREQ_FAST: |
到这里我们第一次碰到了 PIOC 一个很有意思的特点:因为大多数指令的执行时间如此简单且确定,程序代码本身其实也可以被看作一种“时间资源”。一条 NOP 不只是“什么都不做”,它还代表着一个确定长度的时间间隔;而在一连串的 NOP 前改写程序计数器,相当于在运行时决定这一次执行其中多少,也就是把已有的一段执行路径短路掉了一部分。而这里,我们也开始打破 PIOC 看似只能跳过单条和立即数地址跳转的限制。
06.3 为什么连程序布局都开始影响时序
不过,细心的读者应该留意到了:SFR_PRG_COUNT 只是 PC 的低字节。有低字节,也就意味着还有高字节的存在,但是在哪呢?没有,不在已知的 SFR 里。也就是说,这个 SFR 给出的只是 PC 的低字节,能被改写的范围限于当前所在的 256 条指令的页面之内。
这是一个隐藏的陷阱:如果我们在一段连续的 NOP 前操作 PC 时,跳到的目标地址跨越了 256 条指令对齐的页面边界,程序计数器的低字节就会回绕到当前页内的位置,而高字节不变(也就是 8 位加法的溢出),同时导致 PC 落在错误的指令上,控制流遭到破坏。
根据指令集手册的说明,“若使用了 ADD SFR_PRG_COUNT 实现的单字节查表程序,每次修改程序后必须人工检查是否发生过页,因为这类短跳不会在目标地址跨越 256 条指令对齐的页面边界时自动翻页”。我们所用的快路径实现虽然并不是典型的查表程序,但采用同样的 PC 低字节修改机制,因此同样受到这一限制。并且由于这里不是显式的跳转指令,而是运行时直接修改 PC 低字节,这种情况下汇编器无法替我们完成这个检查,因此页面边界必须由程序作者自己保证。
对于普通程序来说,这多少有些像一个恼人的汇编器限制:代码写在哪里,通常只是链接和地址布局的问题,很少影响程序逻辑。在普通 MCU 上,基本上除了 Bootloader 跳转,很少会需要开发者亲自关注程序在地址空间中的安排。但对于我们的快路径实现来说,就远不止这一点点手工检查的恼火而已,它会直接影响输出波形。
我们之所以把前面的那串 NOP 整齐地排在一起,并不是为了空跑 10 次“什么也不做”,这是因为每一条 NOP 本身就代表一个确定长度的时间间隔,并且没有不可接受的副作用。如果程序从第一条 NOP 开始顺序执行,会消耗 10 个周期;如果从第三条开始执行,就只消耗后面的 8 个周期;从第十条开始执行,则只消耗最后 1 个周期。也就是说程序空间里预先写好的那串 NOP 相当于一组顺序排好的“时间刻度”,而 ADD SFR_PRG_COUNT,F 的动作,则相当于在运行时决定“从这把尺子的哪一个刻度开始走”:
| 地址 | 指令 | 执行后经过的时间 |
|---|---|---|
| 0xXX3F | ADD | 修改 PC 固定消耗 2 周期 |
| 0xXX40 | NOP | +1 cycle |
| 0xXX41 | NOP | +2 cycles |
| 0xXX42 | NOP | +3 cycles |
| … | … | … |
| 0xXX49 | NOP | +10 cycles |
| 0xXX4A | BS | 延时结束 |
这样,就实现了粒度为 1 个周期的可变延时,而且不需要在运行时修改程序本身。最长的延时是 k=0 时,跳到下一条 NOP,但由于 PC 被写入导致 ADD 多消耗 1 周期,共消耗 12 周期;最短的延时是 k=10 时,所有 NOP 都被跳过,直接跳到下一个时序指令,共消耗 2 周期。
于是我们发现了一件有趣的事情:程序地址决定执行入口,执行入口决定实际执行的指令数量,而指令数量又直接决定 IO 波形在时间轴上的位置。而 CPU 在执行什么就会在波形上表现出来的这一点,我们先前已经发现了。而且,PIOC 的指令周期高度确定,这意味着在这个快路径实现中,“代码放在哪里”已经不再只是软件工程意义上的代码布局问题,它同时也是时序设计的一部分。可以把它理解成一种非常简单粗暴的“迫真数字延时线”:通过在程序空间里提前放好一串长度固定的时间单元、运行时通过改变 PC 来选择从哪里开始消费这些时间单元实现可控地消耗程序周期。这样,我们并没有在运行时修改这一串 NOP,只是通过控制这一次执行会经过其中的多少条指令,就实现了我们的目的。
前面那个看起来有些莫名其妙的 256 地址页面限制在这里至关重要,通过修改 PC 选择执行入口时,就必须同时满足短跳和 PC 低字节修改的地址限制。否则,若短跳跨越了 256 对齐区域,本来只是想跳过前面几个 NOP 以少等几个周期,最终却可能跳进完全错误的程序位置,直接跑飞。因此,快路径的代码布局不能再像普通函数那样随意调整,必须仔细安排 NOP 区域以及它前面的 PC 修改指令放在哪里、SWCLK 操作在哪里、整个区域是否跨越页面边界等,因为它们都已经成为时序设计的一部分。甚至对这里毫无“算法意义”的填充指令,它们所占据的程序地址也具有实际价值,因为这些地址最终对应的是可以被选择、被消费的时间。
由此我们会发现 PIOC 的程序空间呈现出有趣的双重属性:它既是存放程序的空间,也是可以被开发者安排和组织的时间资源。因为 PIOC 的指令周期足够确定,所以程序地址、执行路径和时间之间能够建立直接关系。
这也是 PIOC 与普通 MCU 软件开发一个很有意思的分界点。在普通 MCU 上,我们通常会努力减少无意义的 NOP;而在这里,一串精心安排的 NOP 恰恰可能是程序中最有价值的一部分,因为它们直接构成了输出波形的时间尺度。当然,一旦代码布局本身成为时序的一部分,快路径实现就不能再被当成普通的“可随意重排、优化”的代码,因为增加一条指令、重排一下顺序,甚至改变某个跳转目标的位置,都可能改变地址关系,从而影响最终时序。因此,从这里开始,我们实际上已经不只是在写程序,而是在同时安排程序的控制流和时间轴。
通过手工调整布局或使用 ORG 伪指令,确保 NOP 短跳转不会跨页后,生成的汇编 LST 文件片段如下。其中 L 表示汇编源文件的行号,P 表示程序空间的地址,C 表示指令码。
1 | L=0071, ......, D=0000 : ; |
其中,我们将 SFR DAP_FAST_CFG 定义如下:
- Bit [7:5]: RFU 保留备用
- Bit 4: FastPath enable 快路径使能
- Bit [3:0]: FastPath skip cycle 快路径跳过的周期数
这样,在每组传输开始时将其低 4 位装入 A 中,并使用 ADD SFR_PRG_COUNT,F 来跳过指定条数的 NOP,从而实现可变延时。这里我们需要确保每一次跳转内部的 P 没有跨页,也就是 P 的高字节在同一段短跳范围内保持相同(在上面的片段中均为 00)。
必须注意的是,当要跳过的指令数量超过 10 条时,就不能继续使用这种方法了,因为跳过的指令数量超过了 NOP 的总数,程序计数器会跳过本该执行的指令并导致控制流错误。这也就意味着,对于修改 PC 跳过 k 个指令的设计,合法的 k 只能取 0 到 10 之间的整数。所以在子程序的开头,有一对 CMPL 10 和 JC DAP_PACKREQ_EXFAST。CMPL k 的含义是“计算 k-A 并影响零标志 Z 和进位标志 C”,它们用于比较“A 是否大于 10”,并在满足条件时跳转到 DAP_PACKREQ_EXFAST 子程序来使用内联的单周期 NOP 处理延时,这也防止了跳过的指令数超过 10 条。
与此同时,在主核的 DAP 实现中关于时钟频率与延时周期的计算函数中,如下实现 PIOC 的时钟周期计算:
1 | // PIOC delay calculation |
这样,传入的延时参数 DAP_PIOC_FastSkip_Cycles 在 0 到 10 范围内表示要跳过的周期数,而当其为 11 时,由于 PIOC 固件中的 CMPL 10 + JC 路径的存在,它就不再表示跳过的周期数,而是表示使用内联单周期延时路径。12 到 15 的值是非法的,主核在计算时会将其限制到 11。
不过,既然可以用这种方法把短延时压到几个周期,那么它究竟能让 SWCLK 跑到多快,又要付出什么代价?
06.4 实测 21.276MHz,但是代价是什么?
现在,我们能够在每个理想化的位中实现最低 2 周期的可控延时:使用当前的快路径结构,每一侧短延时的最小代价仍然不是 0,而是用于修改 PC 需要 ADD SFR_PRG_COUNT,F 本身的 2 个周期。每跳掉一个 NOP 省下 1 个周期,最多能跳 10 个。基于上文所给出的公式,每个理想化的位的总周期数为 2n+5,其中 n 最小可以取到 2,也就是在当前的快路径实现下,每个理想化的位只需要 9 周期,在 CH32V205 @ 192MHz 的时钟频率下约 21.3MHz。
理论上来说,把两处延时都理想化成内联单周期 NOP 延时后,每个理想化的位需要 7 周期,也就是当前实现可达的结构性理论上限频率约 27.4MHz。
重新编译 PIOC 固件并编译整个工程,然后烧写到 CH32V205 上测试。OpenOCD 中指定目标时钟频率为 21000kHz,实际测量 SWCLK 频率约为 21.276MHz。
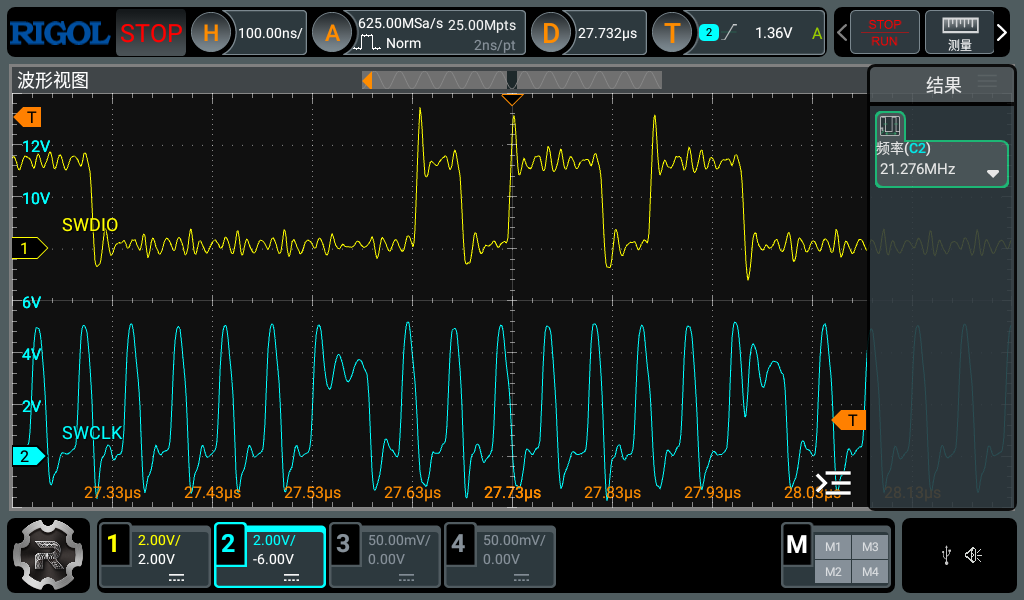
由于笔者只是在开发板上飞线进行的测试,波形的串扰和过冲非常严重,因此图片中的波形仅用于展示时钟频率。也是因为相同的原因,笔者无法完成 27.4MHz 的测试,因为此时过冲和串扰已经严重到了开始产生 SWD 传输错误的程度,也许需要正式地为其设计一个带有良好信号完整性设计的 PCB 来完成全部测试。
至此,DELAY_L2 已经不再是主要瓶颈,此时延时已经只能占到整个理想化的位周期中的 4/9。在周期数最短(每个理想化的位需要 9 周期)的快路径中,两次 PC 修改各占 2 cycles,因此两个延时路径合计占 4/9;剩余 5 cycles 则是数据输出、判断、校验和边沿控制等结构性开销。即使把延时压到最小,取位传送、校验判断与累加、两次时钟边沿这些结构性开销依旧是必须的。说实话,这又是一块被踢到的铁板,而且比我们想象的要结实。但本文的重点并不是用 PIOC 进行“飙车”,而是展示它作为一个可编程、高确定性的数字时序引擎的能力。
07 这个蛋糕到底烤得有多熟?
07.1 OpenOCD 的实际结果
前面几章我们一直在看 PIOC 自己跑得怎么样。可是一个“外设”如果只能在示波器上证明自己波形漂亮,那还远远不够。既然这个 PIOC 已经被接进 CMSIS-DAP 的完整链路里,接下来干脆把它交给 OpenOCD,让标准工具链来检验一下它是否能像真的“SWD 接口外设”一样运行。
首先,列出测试条件:
- 硬件环境:
- x86 兼容型上位计算机
- Intel i5-14500
- 16GiB DDR5-4800
- CH32V205RCT-R0-1v1 评估板(作为调试桥)
- STM32H750VBT6 核心板(作为目标)
- x86 兼容型上位计算机
- 软件环境:
- Windows 11 x64 25H2 26200.9168
- Python 3.14.7
- OpenOCD 0.12.0+dev-g1adf0ee (2026-09-01-14:57)
- 使用 LLM 辅助编写的测速脚本
CH32V205 评估板上运行的是使用 PIOC 处理 SWD_Transfer 事务的 CMSIS-DAP 移植固件,角色是调试桥;STM32H750 核心板闪存已擦除,角色是目标芯片。两者之间只连了 SWCLK、SWDIO 与 GND 三根线。
由于测试脚本较长,不适合完整贴进正文,故先在此简要介绍其测量机制。
OpenOCD 侧用 cmsis-dap.cfg 连接调试桥,用 stm32h7x.cfg 描述目标。测速期间目标始终保持 halt,RAM 通过 AHB-AP 直接访问,不需要目标固件参与。对 OpenOCD 来说,这只是又一个普通的 CMSIS-DAP 调试桥,它并不知道也并不关心 SWD 时序是由 PIOC 生成的,PIOC 的存在对上层是透明的。这一点其实是本节测试有意义的前提:如果 PIOC 版固件不能被标准工具链当成标准调试桥直接使用,前面几章的时序工作就只停留在示波器上。测试的测量主体是端到端的 load_image 和 dump_image,通过 OpenOCD 执行。脚本通过 OpenOCD 的 telnet 接口逐条下发命令,用 adapter speed 逐档覆写 SWCLK,对每个(时钟档位,块大小)组合重复测量并换算成带宽。
本次使用的参数是:
- 时钟档位:1MHz、2MHz、4MHz、8MHz、10MHz、15MHz、20MHz
- 块大小:4KiB、16KiB、64KiB
- 每组合:5 轮有效样本,外加 1 轮首先进行的预热(预热不计入统计)
由于一次传输里混合了某些在同一测试批次中只发生一次的初始化动作(尚未彻底调查清楚具体是什么,但比较可能与上位计算机侧有关),所以每个组合先执行一轮预热,然后再记录 5 轮有效样本。预热轮不计入统计,以避免 OpenOCD、文件系统或主机侧首次访问产生的各种初始化动作等的开销污染稳态测量。为了确保目标状态的一致,每轮样本前脚本还会重新 halt 一次目标。
考虑到可能存在通讯出错的情况,每轮样本都会进行两个校验:OpenOCD 自报的字节数必须与块大小一致,读回的数据必须与写入的伪随机图案逐字节相同。任一条件不满足,说明这次传输出现错误,无法作为有效样本,需要丢弃并重测。
测试结果如下。脚本对每个(时钟档位,块大小)组合都给出写入与读回的中位带宽,共 21 个组合(单位 KiB/s):
| 请求频率 | 4KiB 写 | 4KiB 读 | 16KiB 写 | 16KiB 读 | 64KiB 写 | 64KiB 读 |
|---|---|---|---|---|---|---|
| 1MHz | 81.0 | 78.9 | 82.0 | 78.3 | 82.2 | 80.5 |
| 2MHz | 158.3 | 150.7 | 161.2 | 151.0 | 162.1 | 157.1 |
| 4MHz | 299.1 | 277.4 | 310.0 | 277.9 | 313.4 | 296.6 |
| 8MHz | 482.1 | 432.9 | 506.8 | 436.9 | 513.8 | 475.1 |
| 10MHz | 627.2 | 537.7 | 667.1 | 550.6 | 680.1 | 620.4 |
| 15MHz | 779.1 | 635.6 | 841.7 | 656.1 | 862.2 | 761.1 |
| 20MHz | 920.8 | 746.8 | 1017.6 | 758.5 | 1038.3 | 852.3 |
上表用的是中位结果,它是本节比较时的主要口径:中位数剔除了离群样本,适合横向比较链路本身的常态表现。同一批数据还有第二种口径,即取全部有效样本均值的“用户感知”值,把偶发卡顿也算进去,对应实际使用中能体验到的速度;在多数档位上两者相差不到 1%,说明调试桥的链路在该测试工况下抖动较小。21 个组合全部是 5 轮有效样本、0 轮丢弃,写耗时样本的 σ 不超过 0.2ms,最小值与中位数相差不超过 0.4ms;逐档的 σ、min 与用户感知均值见本节末尾的折叠区。
与此同时,由于测试的是包含上位计算机及 OpenOCD、USB 主机协议栈等一系列软硬件在内的复杂系统,直接测得的读写速度数据中存在固定开销稀释。一次 load_image/dump_image 里有一份与块大小无关的固有成本(也就是表中固定开销那一列,约 0.5ms~0.8ms),上表中 4KiB 一列的带宽被这份固定成本稀释得比较明显。为了减少固定开销对小块测试的影响,脚本对不同块大小做线性回归,并使用斜率对应的渐近吞吐进行比较。这个指标更适合观察数据量增大之后的边际吞吐,但它仍然是整个 load_image/dump_image 路径的端到端指标,并不能单独代表 SWD 或 PIOC 的理论能力。对写路径按块大小做线性回归,可以把固定成本与真正的边际成本分开:
| 请求频率 | 固定开销 (ms) | 边际成本 (µs/B) | 渐进带宽 (KiB/s) |
|---|---|---|---|
| 1MHz | 0.82 | 11.863 | 82.3 |
| 2MHz | 0.67 | 6.014 | 162.4 |
| 4MHz | 0.69 | 3.105 | 314.5 |
| 8MHz | 0.56 | 1.892 | 516.1 |
| 10MHz | 0.56 | 1.427 | 684.1 |
| 15MHz | 0.56 | 1.124 | 868.6 |
| 20MHz | 0.48 | 0.933 | 1046.7 |
回归斜率对应的渐进带宽才是数据量足够大之后的边际吞吐,也是后文讨论瓶颈时使用的口径。
完整原始输出(脚本 stdout)
1 | ===== SWD 时钟 1000 kHz (回读请求值 1000 kHz) ===== |
结合数据,可以认为当请求的 SWCLK 达到 20MHz(快路径下的实际频率约为 21.276MHz,见 06.4)时,OpenOCD 通过这条链路往目标 RAM 写入的实测带宽大约是 1MiB/s。
但是在提出任何对速度的评价之前,需要明确一点:这不是一场 DAPLink 竞速比赛。STM32H750VB、OpenOCD 以及 x86 主机上的 USB 链路,都只是承载被测对象的载体。本节真正关心的问题是:PIOC 烤出来的这个外设,在真实的应用场景下可用性如何、表现怎么样。
07.2 20MHz SWD 理论上能有多快
那么,理论上呢?假如说我们把整个调试完全理想化,使得所有传输事务的传输瓶颈完全受制于 SWCLK 的频率,理论上能使得 SWD 吞吐达到多少呢?
考虑一次完整的 32 位 SWD 传输事务,按请求头 8 位、换向 1 位、ACK 3 位(且回复的是 OK)、换向 1 位、数据 32 位、校验 1 位计算,合计 46 个时钟周期。
这里要先修正一个容易出错的细节。07.1 中的“20MHz”是下发给 OpenOCD 的请求值,并不是真实的 SWCLK 频率。第六章已经说明,快路径下每个 SWD 位固定对应 9 个 PIOC 周期,因此请求值一旦超过快路径能够达到的上限,实际频率就会停在 192MHz / 9 附近,也就是 06.4 实测到的 21.276MHz。换句话说,这一档数据实际上是在 21.276MHz 下跑出来的,因此下面的理论估算基于实际的频率测量值进行:
$$21.276\text{MHz} \times 4\text{Byte} \div 46 \approx 1.85\text{MiB/s} \approx 1807\text{KiB/s}$$
对照 07.1 的实测结果:20MHz 档位下 64KiB 块的写入约 1038KiB/s、读回约 852KiB/s,分别约为 1807KiB/s 的 57% 和 47%。
这意味着什么?首先,这说明 SWD 的位时序还有相当的空间可以挖掘(理论上还有接近一倍的空间);但它并不能说明 PIOC 慢。必须注意的是,这个模型里有许多理想化假设:
- 每个 32-bit SWD transaction 需要 46 个 SWCLK 完成
- SWCLK 在两次传输之间从不停顿(连续无气泡)
- 每一次 AP 访问都能立刻得到 OK 响应,绝不出现 WAIT 或 FAULT。
在这一模型下,约 1807 KiB/s 是该使用该模型推导出的理论吞吐速率上界。但是真实的 DAP 事务里,可能这些无法保证全部成立,所以这个速度并不是一个“本该达到”的目标值。
07.3 这个数字究竟测到了什么?
那如果说整个 SWD 总线的吞吐率才只达到了理论极限的约一半,那目前测到的结果究竟能说明什么?
07.1 一节中已经提到过,测试使用的 load_image 和 dump_image 是端到端的 Benchmark,测的是“用 OpenOCD 把一段数据搬进或搬出目标 RAM 需要多久”,而不是“PIOC 执行一条命令需要多久”,同样的脚本完全可以用来测试其它兼容 CMSIS-DAP 规范的调试桥,因为 OpenOCD 并不关心调试桥的时序是如何发生的。尽管 OpenOCD 提供 fast_load_image 等将文件预先载入上位计算机 RAM 中的方法,但由于本文的测试目标是“真实应用场景下使用 PIOC 外设”的端到端体验,故没有使用。
以一次 load_image 操作为例,从外层到内层要经过的环节大致如下:
| 环节 | 执行者 | 说明 |
|---|---|---|
| telnet 命令收发 | 主机上的脚本与 OpenOCD | 计时区间的起点与终点在这里 |
| 文件读写 | OpenOCD(主机侧) | 读取源文件、写回读出的数据(文件系统可能存在开销) |
| USB 传输 | 主机 + 调试桥固件 | 批量端点,受主机侧调度影响(受 USB 主机实现影响) |
| DAP 命令解析与队列 | 调试桥主核 | 把 DAP 事务拆解成 SWD 位操作 |
| PIOC 命令下发与等待 | 调试桥主核与 PIOC | 主核与 PIOC 的命令握手 |
| SWD 位时序 | PIOC | 20MHz 这个上限只作用在这一段 |
| SW-DP / AHB-AP 事务 | 目标芯片 | 每次传输的固定协议开销 |
| SRAM 访问 | 目标芯片 | 目标侧的存储器访问 |
计时区间从发出 telnet 命令开始,到收到 OpenOCD 提示符结束,上表里的每一环都落在这段区间内。换句话说:
- 20MHz 的 SWCLK 只决定了“SWD 位时序”这一环的理论上限;
- PIOC 的执行速度也只体现在这一环上;
- 调试桥主核的 USB 处理与 DAP 解析、USB 传输本身、OpenOCD 的 Tcl 解析与文件读写、telnet 往返、目标侧的 AHB-AP 与存储器访问等全流程的端到端开销,全部计入结果。
因此如 07.1 一节所说,1MiB/s 是“包含上位计算机及 OpenOCD、USB 主机协议栈等一系列软硬件在内的整个系统”的成绩,并不是“PIOC”单独测试的成绩。反过来说,这个速度和理论上限值之间的差距,已经相当一部分的锅都不能丢到 PIOC 头上了。比如,我们很容易发现 4KiB 小块的带宽明显低于 64KiB 大块,而表中“固定开销”那一列(约 0.5ms~0.8ms)正是这条路径上“与数据量无关”的那部分开销。
由于目标全程处于 halted 状态,调试器访问的是 AHB-AP 直连的 RAM,因此这个结果里不包含目标固件运行、Flash 编程、断点与单步之类的时间,只是使用内存读写的方式测试 SWD 链路的带宽,而不是调试桥在完整调试场景下的表现。而由于 load_image/dump_image 本身是包含文件 I/O 的完整操作,而不是一条纯粹的传输命令,文件系统也可能会引入一部分固定开销。
那么问题来了:如果这个测试结果中包含大量与 PIOC 无关的影响因素,那它到底能说明什么?
其实正好相反。本节最开始提出的问题是:PIOC 烤出来的这个外设,是否能在真正的使用场景中发挥作用。这不是一个能靠局部测试回答的问题。比如在 CH32V205 上直接向 PIOC 发起若干次 SWD 事务、检查波形是否正确,这只能证明“PIOC 能产生符合要求的 SWD 时序”,也就是证明了那段程序本身是对的,但是对于“PIOC 能不能作为有实用价值的外设用”的论点缺乏说服力。要验证这一点,就只能把它放回真正使用它的位置:由一套完全不关心 PIOC 存在的上位工具链来驱动,并且同时面对 USB 传输、DAP 协议解析、超时与恢复、主核与 PIOC 的协同等一系列与位时序无关的要求。如果端到端的测试结果很差,那么局部时序再精确也说明不了什么:一个在真实系统里跑不出可用带宽的实现,不足以成为一个具有实用价值的外设。
然而现在这个结果说明的 SWD 链路是通的,而且我们可以开始怀疑它的瓶颈不全是 PIOC 导致的。更重要的是,这个测试结果覆盖了整条路径在多种工况下的表现,具备一定的诊断价值,进行适当的统计分析,就能反过来排查瓶颈主要在哪里。
07.4 从曲线看,真正的瓶颈在哪里?
先上个图吧,这样直观一些。
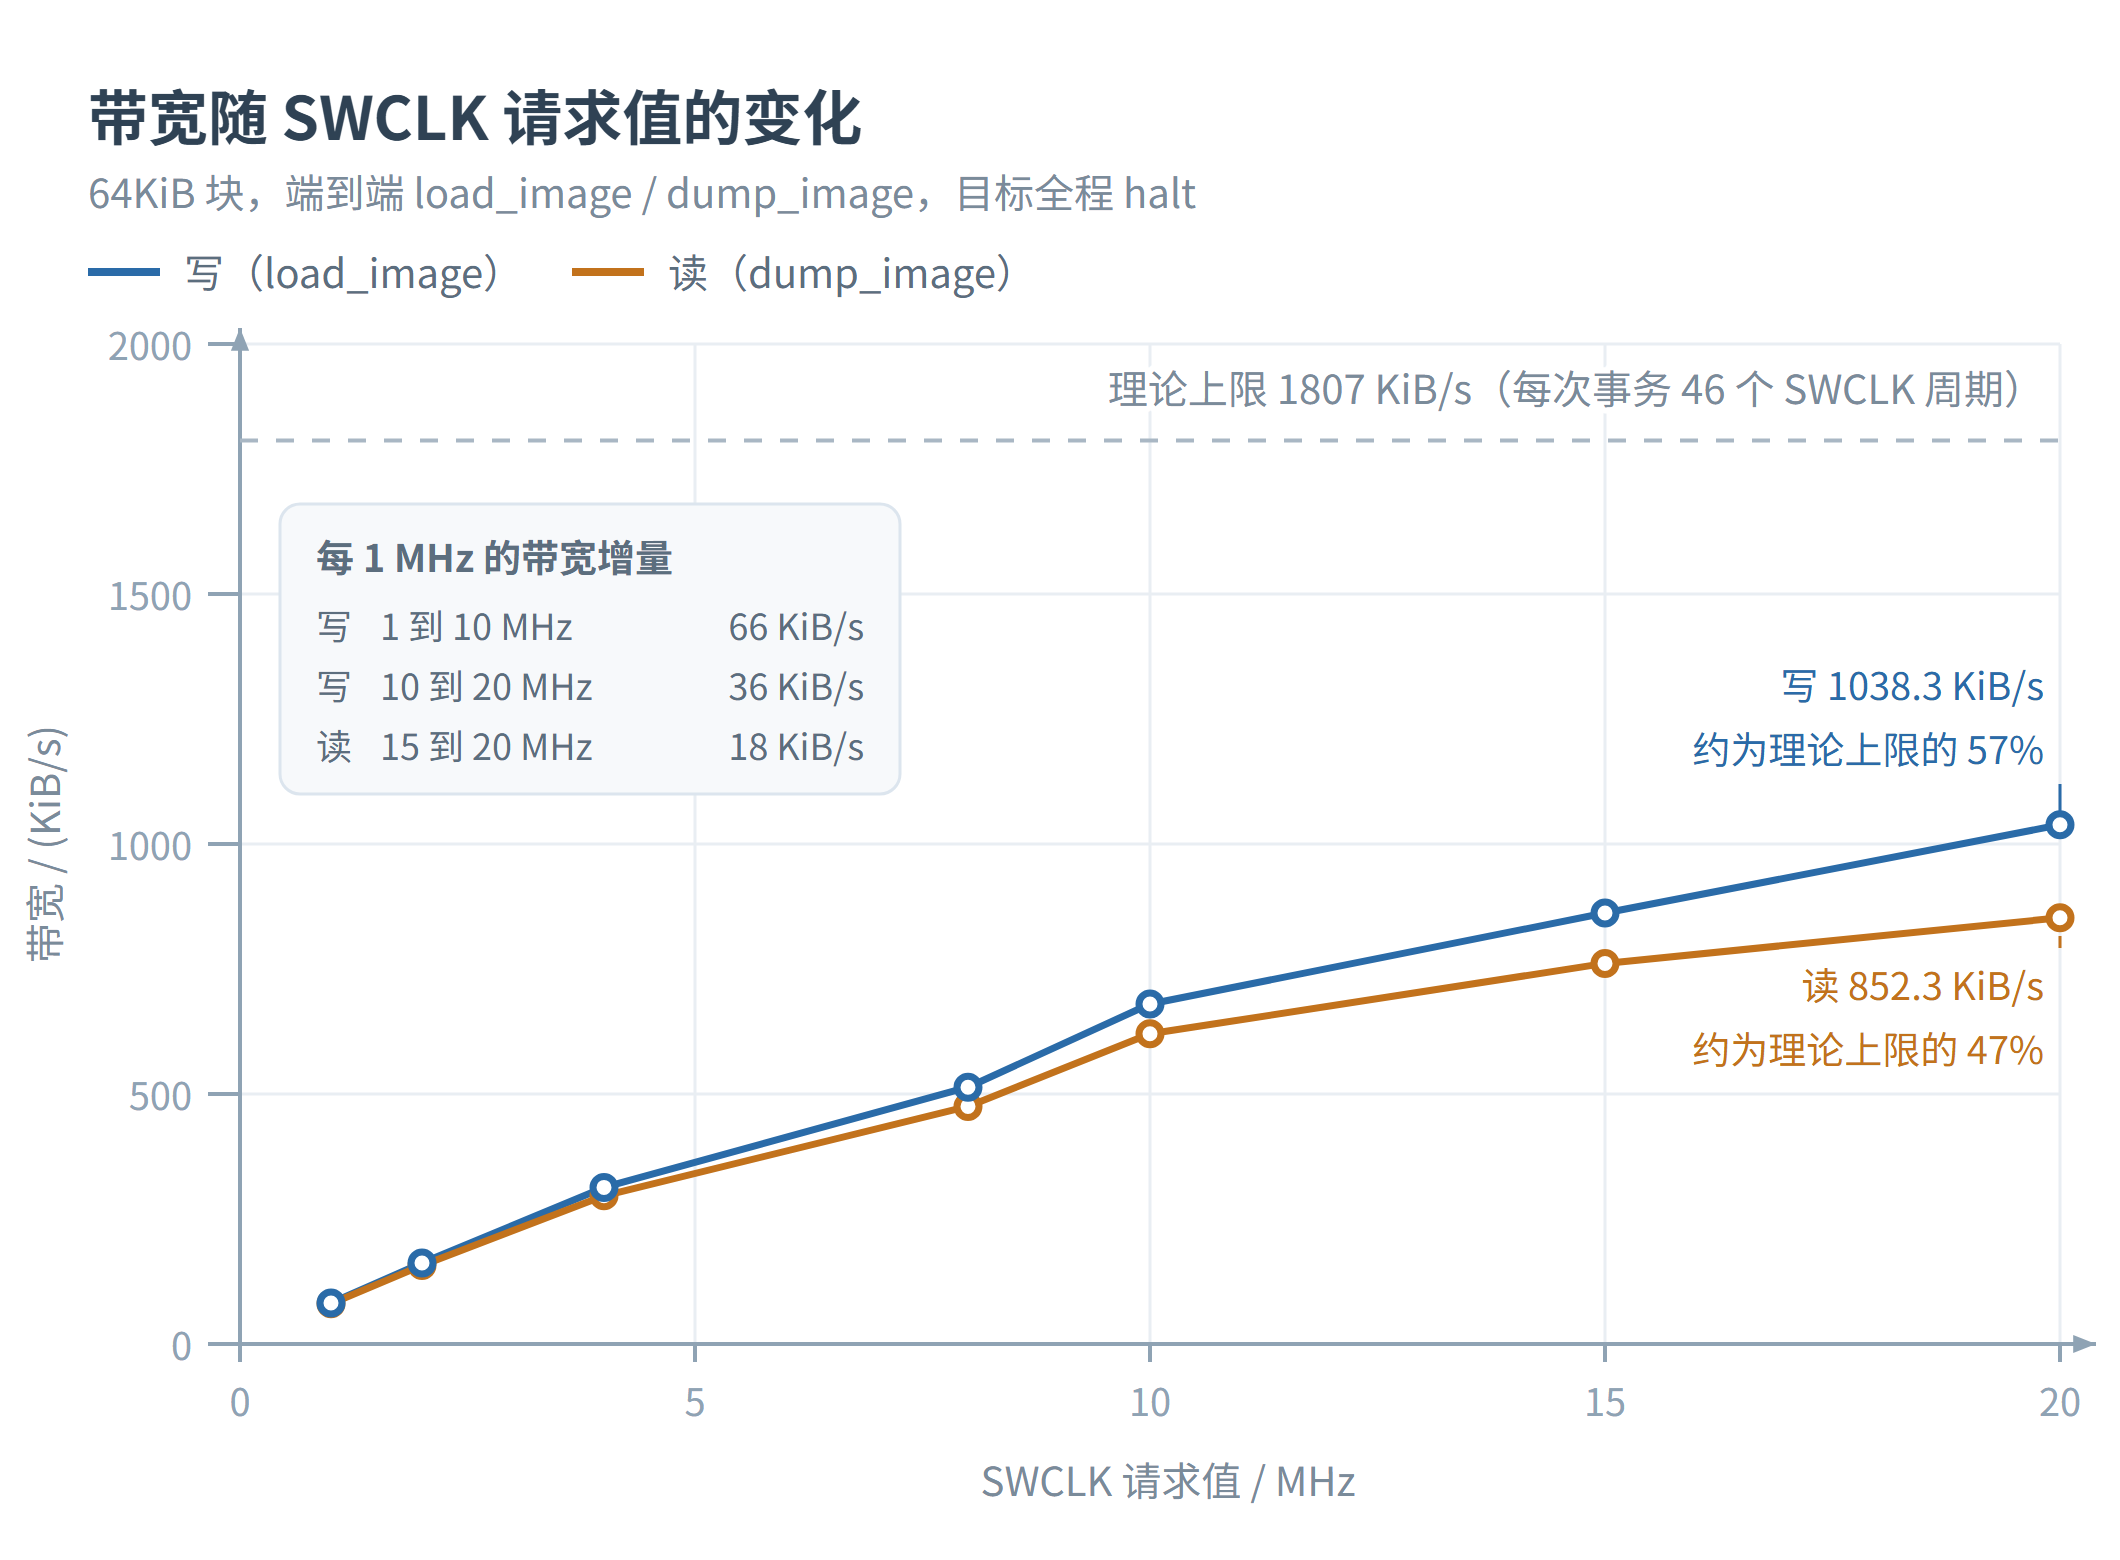
从趋势来看,从 1MHz 到 10MHz,64KiB 块的写带宽从 82KiB/s 增长到 680KiB/s,平均每提升 1MHz 换来约 66KiB/s 的增量,大致是线性关系(横轴用的是下发请求值;快路径档位的实际频率与请求值存在偏差,其中 20MHz 档实际测量验证为 21.276MHz)。10MHz 到 20MHz,带宽继续从 680KiB/s 增长到 1038KiB/s,绝对量还在涨,但每 MHz 只能换来约 36KiB/s,单位时钟的收益明显下降。读路径的上升斜率更早变缓:15MHz 到 20MHz 只从 761KiB/s 涨到 852KiB/s,每 MHz 约 18KiB/s。
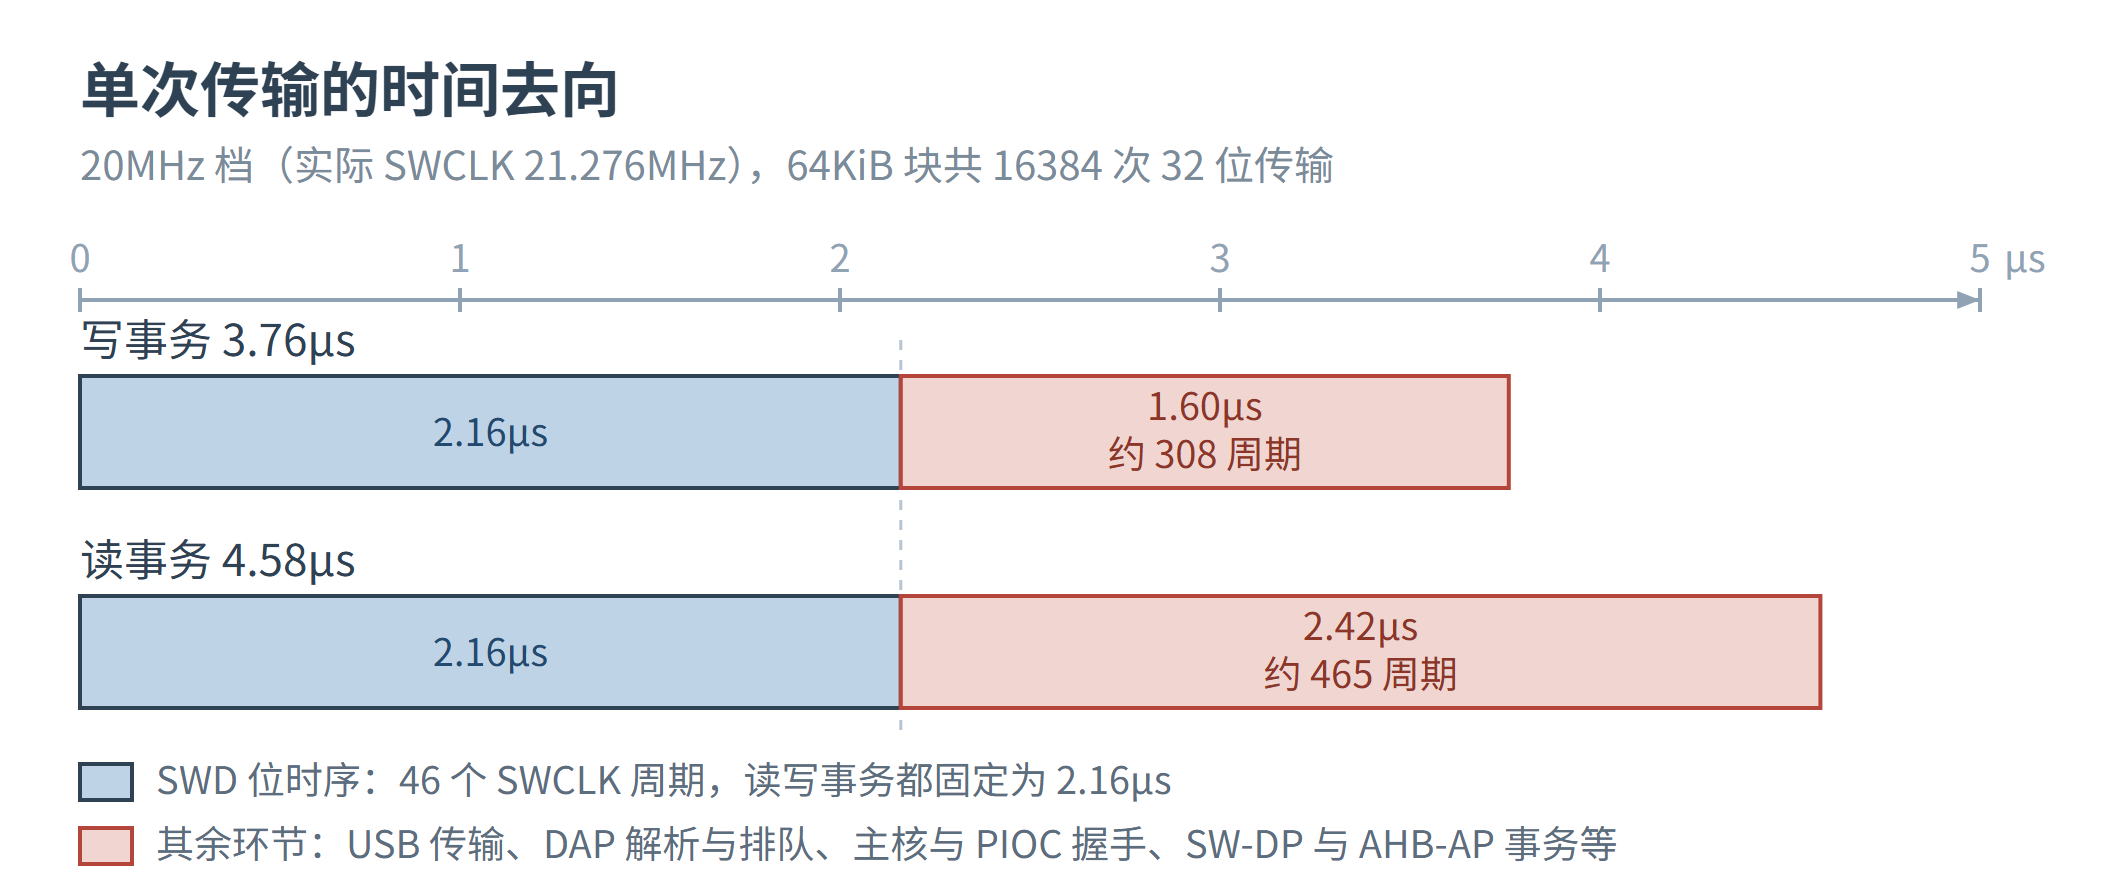
如果从 SWD_Transfer 传输事务的次数来看,64KiB 是 16384 次 32 位传输,实测写入耗时 61.64ms,平均每次 3.76µs;而按 46 个时钟周期、21.276MHz 的真实 SWCLK 计算,SWD 位时序本身只需要约 2.16µs。也就是说,每次传输平均还有约 1.6µs 没有花在 SWCLK 上,折合 192MHz 主核的约 307 个周期。读路径的差额更大,约 2.4µs,折合约 465 个周期。
这些锅不能全丢给 PIOC 来背,因为其中相当一部分都分布在 USB 传输、DAP 包的解析与排队、主核与 PIOC 的命令握手、SW-DP 与 AHB-AP 的事务开销等环节,这也是端到端测试的一个特点:结果好能说明所有组件都在良好协同运行,但是结果不好却无法单一地直接指向具体的某个组件问题。但以上分析足以说明,当请求的 SWCLK 达到 20MHz 时,限制吞吐的主要环节已经不在 SWD 位时序上了。
尽管单靠端到端的事务时间分解,可以认为当前系统存在大量非 SWD 位时序的开销,但仍然不能单独判断这些开销究竟属于上位计算机、主核、PIOC 握手、USB 还是 OpenOCD。
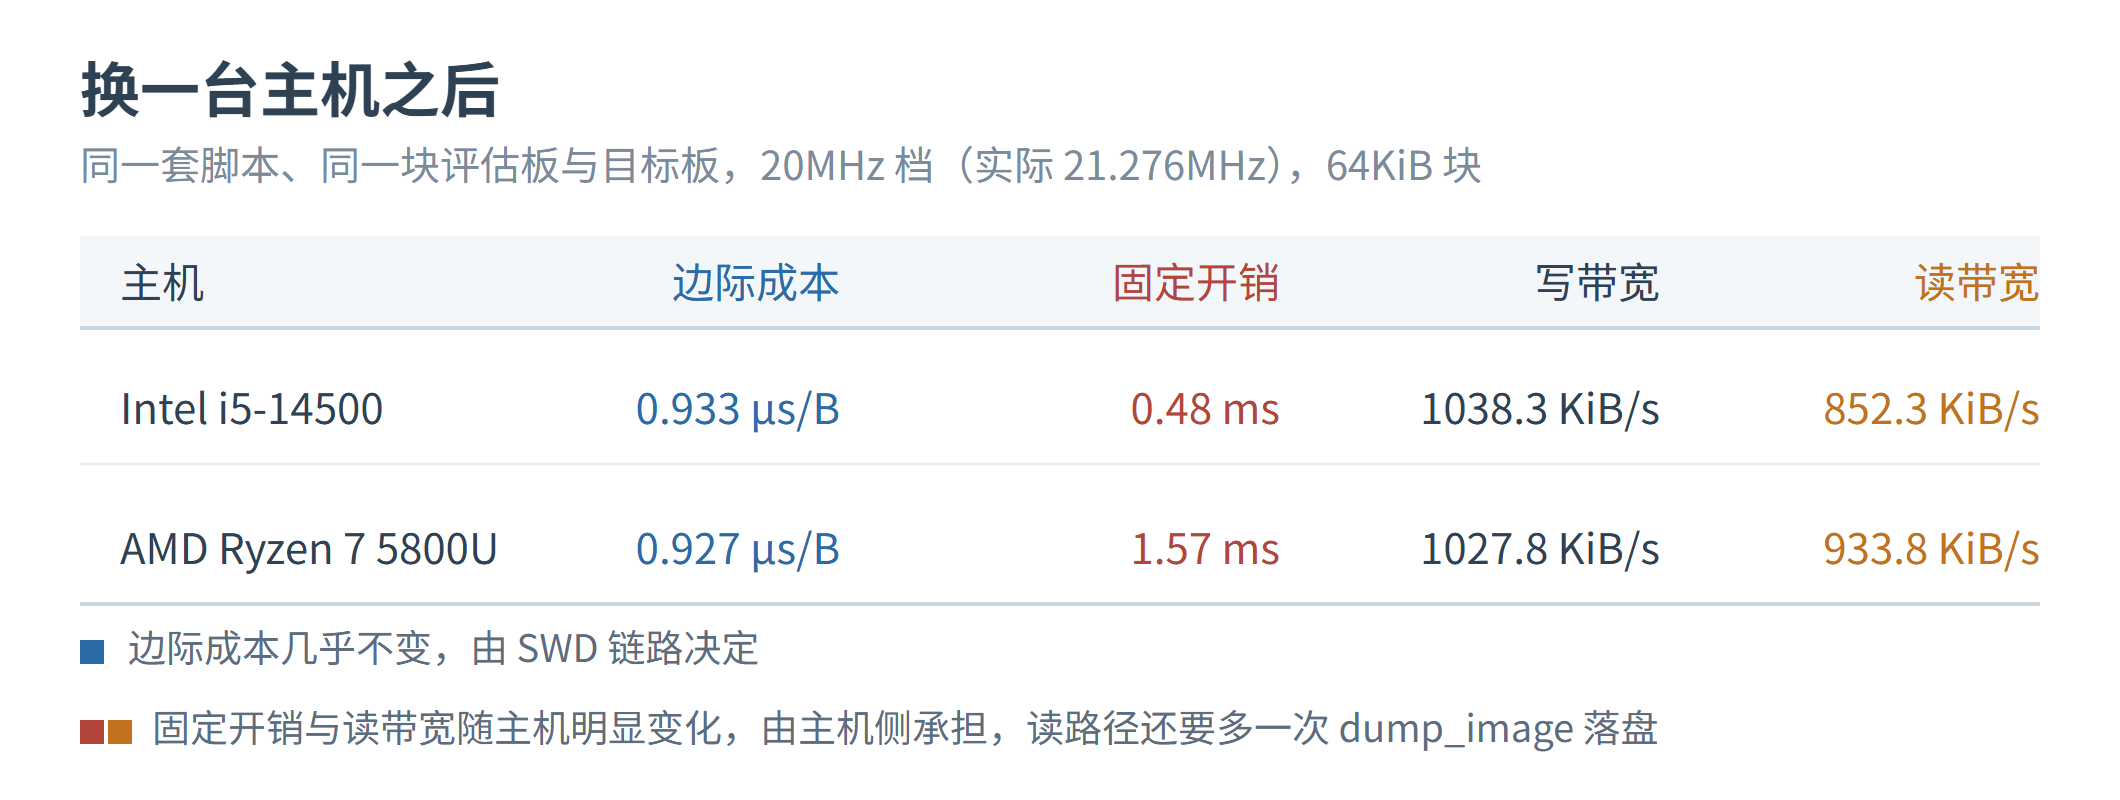
一个有趣的测试数据是,在使用同一套脚本、同一块评估板+目标板的硬件条件下,只把上位计算机从 Intel i5-14500 的这一台(前面测试用的)换成一台 AMD Ryzen 7 5800U 的笔记本电脑时,20MHz 档位的写带宽从 1038.3KiB/s 变为 1027.8KiB/s,下降微乎其微;按块大小线性回归得到的每字节边际成本从 0.933µs/B 变为 0.927µs/B,也几乎不变。但每条命令的固定开销从 0.48ms 升到 1.57ms,读路径带宽则从 852.3KiB/s 变为 933.8KiB/s。边际成本几乎不受上位计算机影响,说明这一部分成本并不明显受主机 CPU 性能影响,而更可能由双方共享的链路或协议处理路径决定;固定开销和读路径明显随上位计算机变化,这至少说明固定开销和读路径中存在明显的主机侧因素,提示我们很可能其中有相当一部分是由上位计算机侧承担的,尤其是注意到读路径的 dump_image 落盘会产生文件系统写操作的情况下。
这两组数字的行为差异,正好印证了 07.3 的结论:这个 Benchmark 测的是一条完整的路径,而不是其中某一环。1MiB/s 这个结果里,由 PIOC 产生的 SWD 时序只是其中一项,而且随着时钟频率的升高,它占的比重还在继续下降。
07.5 这个成绩到底意味着什么
首先,21.276MHz SWCLK 下对 RAM 进行测速,得到“约 1038KiB/s 的写入、852KiB/s 的读回”的结果,并不是为了在性能上与其他调试桥进行竞争,主要是进行一次可行性验证。不过既然是验证,总得有个参照,至少大致确认这个端到端的成绩是否算是“烂到没有使用价值”。
于是笔者在互联网上找到了以下信息:
- 2017 年 OpenOCD 开发者在优化 CMSIS-DAP 的多 HID 请求流水线时,用 10MHz SWD 配合 USB 高速接口,在 384KiB 连续 RAM 上测到的结果大约是 dump 345KiB/s、load 366KiB/s
- ST 社区中的用户在讨论 STLINK-V3MINIE 时给出的估算是,按 24MHz SWD、32 位数据、每次事务 46 个时钟周期的模型,连续内存吞吐的理论值约为 2038KiB/s,而他们实测 STM32H7 的大块读取只有约 549KiB/s,并指出相当一部分时间消耗在 SWD 之外。
这些数字的目标芯片、调试桥、OpenOCD 版本和测试条件各不相同,不能拿来直接排名。但它们共同指向同一个事实:在真实的 CMSIS-DAP 调试桥的应用场景下,“SWCLK 有多快”从来不是决定吞吐量的唯一因素,上位计算机侧的实现、事务链的流水化程度、USB 传输方式、DAP 包的批量处理、目标侧的存储器访问,都会参与进来。
因此对本文来说,重要的不是这个数字在调试器里排第几,而是它证明了什么:
- PIOC 可以承担一个完整的实时两线协议:需要双向换向、需要根据从机响应分支、需要现场累加校验位、需要按目标频率动态改变位周期;
- 这个实现能被标准工具链直接当作一个普通调试桥使用,OpenOCD 侧不需要任何针对 PIOC 的特殊适配;
- 严格时序被剥离之后,主核剩下的工作是 USB、DAP 解析和参数计算,这些工作与 IO 波形不再有耦合。
也就是说,这个 Benchmark 的目的一开始就是证明架构命题,而不是刷性能排名。对本文这个以 PIOC 负责实时 SWD 时序、其余功能保持标准 CMSIS-DAP 接口的实现而言,在本文的测试工况下,约 1 MiB/s 已经证明它可以承担连续 RAM 调试访问,而不是只能在示波器上证明“波形正确”;但如果目标是追求高性能调试桥的极限吞吐,这个数字距离 SWD 事务层上界仍有明显差距。
从 07.4 的分解还能看到一个有意思的推论:20MHz 档位(实际 SWCLK 为 21.276MHz)下,每次传输平均还有约 307 到 465 个 192MHz 周期没有花在 SWCLK 上,这说明当前限制吞吐的环节并不在 PIOC 产生位时序的能力上。而进一步通过 GPIO 标记观察 PIOC 执行窗口,可以确认在不少时间区间内 SWD/PIOC 实际并未持续占满链路,因此至少可以排除“PIOC 持续满负荷执行才是整个系统唯一瓶颈”的解释。就是说,这个 1MiB/s 既不是 SWD 事务层的上限,也大概率不是 PIOC 这个时序引擎本身的上限。
至少,从目前这组端到端的测试数据来看,没有证据表明 PIOC 产生的位时序执行本身是整个系统的唯一主要瓶颈;并且随着 SWCLK 的频率提高,更多比例的时间消耗在 SWD 位时序之外。
08 为什么这颗“小 CPU”反而适合做 IO?
08.1 主核的困境
当 SWCLK 高达 21.3MHz 以后,端到端链路里真正拖后腿的部分很可能不是 PIOC,这个结论本身并不意外。不过一个更有趣的问题是,在同一个物理芯片中由相同的时钟频率驱动,为什么“短小精悍”的 PIOC 反而相比主核更适合做 IO?可能有的读者马上会给出答案:因为 PIOC 快。
然而在继续讨论之前,有必要明确“快”的含义。至少在当前的语境下,它至少包含两个可能的含义:
- 每秒能执行多少操作
- 某个操作会在第几个周期立即发生
这两种含义实际上有完全不同的应用场景和实现逻辑。对大多数程序来说,往往看重的是第一个意义上的快,处理器越快、算力越强,同样时间下处理的数据更多;但如果我们的目的是让某一次操作严格落在指定的那一刻,那么第二个意义上的“快”才是关键:能否确定性地在指定位置执行预期的操作,甚至它其实已经不应该叫“快”,而应该叫“强确定性”。产生严格可预期的 IO 时序只是这类需求中的一种。而 PIOC 和主核的差别,恰好是在“快”的侧重有所不同。
首先,这个差别并不是主频造成的。PIOC 一般与系统同主频,尤其是在本文使用的 CH32V205 平台上,主核和位于 HB 上的 PIOC 的时钟都来自于 HCLK,都是 192MHz,所以这里不存在“谁的主频更高”的问题。尽管本文中使用的 CH32V205 的主核是 RISC-V,但以下讨论主要针对通用 MCU 内核与专用 IO 执行单元之间的共性差异,不依赖某一种具体 ISA;具体的指令周期、总线行为和中断模型仍然需要结合具体内核实现。
通用型 MCU 内核(也就是本文所说的“主核”)的设计目标通常是较高的整体吞吐:在给定时间内完成尽可能多的程序工作。而具体的实现手段可以差异很大,有的内核流水线很简单,有的会加入预取、缓存等机制,但它们共同面对一个问题:CPU 同时承担的是一整个系统的工作,而不仅仅是一段 IO 时序,需要让整个系统的性能得到提升。
不过,这些措施的副产物之一是微观时间上的不确定性。取指等待、跳转冲刷流水线、用 MMIO 方式外设寄存器要走几个总线周期,都会让同一条指令在不同时刻经过不同的时间才被执行并生效,“某一条指令究竟在哪一刻被执行”成为了一个受到执行上下文影响的多参数问题;此外,内核还要随时准备响应中断,而中断请求会在架构规定的可抢占时机介入当前执行流,并引入额外的响应和处理开销。对大多数程序来说,这个代价足够小,常常可以忽略:以 CH32V205 为例,以最坏情况估计的几百个周期对于 192MHz 的主频不过一两微秒,相对于毫秒级的任务来说太小;当在数百毫秒乃至数秒、数十秒的尺度上来看时,这些微观尺度的波动大多被平均掉,宏观上的耗时反而更稳定收敛于一个稳定的值。而在大部分应用场景下,我们关心的往往是它平均跑多快、能不能在给定的时间段内完成某项任务,而不是其中某一条指令执行的精确时刻。
这里需要注意一点,一条指令自身的执行延迟在很多简单 MCU 上其实相当确定,但是真正麻烦的是它相对于系统时钟、外部世界最终在什么时刻生效,其实会受到整个执行上下文的影响,甚至包括中断、RTOS 调度等综合工况。在 IO 时序应用中,这种副产物显然成为了麻烦的来源之一。以 06.4 中的计算结果为例,21.3MHz 时钟的快路径下,一个理想化的位周期只有 9 个 SWCLK 周期(约 47ns),而上面这些因素里的任何一项,换算成时间也有几十纳秒,已经和整个位周期相当甚至更大。尽管许多简单 MCU 上同样能够实现相对精确的时序,但这往往要求把它完全变成“这段时间内专用于 IO 时序的处理器”,最常见的手段就是关中断。
而更棘手的一点在于,数字协议规定时序的方式要求每一个微观的时序都符合规范要求,宏观上的时序稳定并无帮助。例如有的协议以相对于时钟线的定时作为规范(比如 I2C、SPI 以及本文中的 SWD),有的以绝对定时作为规范(比如 DS18B20 的 1-Wire 使用的微秒级时隙)。无论哪一种,都要求每个边沿或时隙各自在微观层面上是精确符合规范的。也就是说,通用内核上要确定一段程序平均要消耗多少周期相对容易,但是难以决定某条指令确定性地在某一刻被执行。
08.2 确定性可能比算力更重要
在 PIOC 上,执行模型明显不同于为平均吞吐优化的通用内核,它优先保证了第二个意义上的“快”,也就是指令执行时刻的确定性。CH32 中的 PIOC 采用了基于单时钟周期精简指令集的 RISC8B 内核,且一个机器周期就等于一个时钟周期。
由于一些 RISC8B 指令集中的指令在 PIOC 中并不可用或不存在,例如 WRCODE 不可用,因此下面只讨论 PIOC 实际可用的指令。对本文讨论的 PIOC 实现,其公开的指令集的周期模型简单到只有这样:
- 这个指令是
RDCODE吗?- 是:2 周期。
- 否:这个指令执行后会发生跳转(例如
JMP、CALL、RET以及JNZ等条件跳转在条件成立时的情况),或是写入 PC 吗?- 是:2 周期。
- 否:1 周期。
除此之外,PIOC 的 IO 也不是像大部分现代 MCU 那样需要通过总线访问的 MMIO 外设地址,而是可以直接通过指令操纵:指令集中提供了单周期的指令用于置位、清位、把 SFR 的某位写到引脚、读引脚写入 SFR 的某位,等等等等。主核改变 GPIO 时通常要通过内存映射的外设接口访问 GPIO 外设,其可见时序还需要经过主核的访存路径和外设总线;具体延迟可能高度确定,也可能受到流水线、等待状态、总线仲裁等因素影响。相比之下,IO 口的操作在 PIOC 自身的执行流内部相对于程序指令序列的位置是确定的,因此只要程序路径确定,就完全可以在编程时就确定这条指令在哪个 PIOC 周期被执行。
所以,“每秒吞吐量”和“在确定的时刻立即执行”都可以被解释为“快”的内涵,但却是两个不同的方向,而 PIOC 的设计目标是后者:强确定性。
以 06.1 中的 DELAY_L2 为例,它的时长并不是写死的,而是由两个运行期参数 D1 和 D0 决定,而且这种“纯指令软延时”许多人都知道在现代 MCU 上受到各种因素影响极大,定时精度有可能非常差,按理说正是那种“必须实测为准”的代码。但在 PIOC 上,完全可以确定性地计算出来。
为方便讨论,这里先给出结论。DELAY_L2 的控制流可以抽象为两个循环,第一个循环每轮消耗 768 周期,称为“大循环”,轮数由 D1 控制;第二个循环每轮消耗 3 周期,称为“小循环”,轮数由 D0 控制。四种 D1、D0 取值情况下的调用开销(含 CALL 与 RET)如下表,完整的逐段推演请见文末的附录 A。
| D0>0 | D0=0 | |
|---|---|---|
| D1>0 | 768×D1+3×D0+7 | 768×D1+9 |
| D1=0 | 3×D0+8 | 10 |
更值得注意的是,D1 和 D0 并不是编译期常量,而是主核设置 SWCLK 目标频率时算出来、再写进 SFR 的运行期参数。也就是说,这段延时的长度在每次 PIOC 调用之间都可能改变,但它的指令时序仍然是高度确定的:循环只可能走“跳转”或“不跳转”两条路径,D1 和 D0 又各有“=0”和“>0”两种取值情况会影响控制流,于是只需按这四种情况分别把各段指令的周期数相加,就能推出上面那张表。这正是 06 章中计算“一个理想化的位需要多久”得到的 21.3MHz 理论值与实际测试值高度接近的根本原因,执行一段程序所需要的时间是可以数出来的。
而之所以 PIOC 的时序如此高度稳定,很大程度上是因为它为 IO 时序高度特化的设计:
- 不存在类似通用 CPU 的中断响应机制,也没有指令缓存,不确定性更小。
- 指令集直接提供了单周期 IO 位操作,不需要经过主核那种普通 MMIO 外设访问路径。
- 流水线的影响极其简单:写 PC 多扣 1 周期。
06.3 里那张“时间刻度”表其实就是这么数出来的:ADD SFR_PRG_COUNT,F 因为改了 PC 而固定消耗 2 周期,再加上 k 条 NOP,一共 2+k 周期;跳过的 NOP 越多,这一侧就越短。
当然,这同样是有代价的:PIOC 没有独立的 RAM,没有通用处理器那样丰富的算术指令和资源,只有两个 IO 可以控制,程序空间最多存下 2047 条指令,为 IO 和位操作优化的指令集高度精简。它甚至可能不能算一个通用处理器,它更适合被当成专门为 IO 时序设计的“协处理器”。
也就是说,主核擅长处理复杂的系统逻辑,PIOC 擅长安排严格的 IO 时序。
08.3 不要把 PIOC 和主 CPU 比“谁更快”
读到这里,很容易得到一个看起来很合理的结论:PIOC 一条 BS 就能把引脚拉高,而主核在 C 里写一句 GPIOB->BSHR = ...,编译出来是先加载外设基址、再往对应地址写数据的一小段指令(例如几条 load 加一条 store,具体取决于编译器和优化级别),那是不是说明PIOC 做 IO 比主核更快?
也不能完全认为它就是错的,但是这个结论的确经不起推敲,理由如下:
第一,这样一段指令序列代表不了“主核的 IO 能力”。bit-bang 的时序往往依赖 C 编译器生成的指令序列,而同一句 GPIOB->BSHR = ... 在不同编译器、不同优化选项下完全可以编译成不同的序列:基址可以提前留在寄存器里,也可能因为地址范围和周边代码而多出几条指令。用一段特定的汇编去论证“主核 bit-bang 就是慢”,实际上掺进了整个编译过程,不能直接归结为“主核做 IO 不如 PIOC 快”。
第二,就算主核真的要逐周期操作引脚,它也从来不缺别的办法。SPI、I2C、UART、TIM 这些做进硅片的外设几乎可以顶着总线时钟的上限跑,配合 DMA 还能自己把数据搬进外设寄存器,整个过程不需要 CPU 参与;驱动 WS2812 的常用方案之一就是 TIM+DMA 或 SPI+DMA。可见“主核要至少两条指令才能改一个引脚”这个结论,必须外加“用 C 语言逐位 bit-bang”这个约束才成立。
第三,更加根本的是,即使把 IO 操作压缩成一条指令,问题也不主要在于“快不快”,而是“它究竟在什么时候对外产生效果”。对于通过 MMIO 访问 GPIO 的主核而言,GPIO 操作需要经过主核的访存和外设访问路径,这个路径的具体时序取决于具体内核、总线结构和当前系统状态;与此同时,中断还可能横插一脚抢走 CPU 时间;甚至,一条“单周期”指令在现代 MCU 主核上所消耗的时间,往往很可能不止一个机器周期。
所以,把定位完全不同的两者直接拿来比高低,本身就是一件困难的事,结论也很有限。本文的例子选择的分工是:主核负责调试桥上的 USB 通讯、DAP 解析、参数计算、超时恢复,PIOC 只负责 SWD_Transfer 事务的 IO 时序,让它们在正确的时刻发生。07 章的测试也表明,当 SWCLK 升到 21MHz+ 以后,瓶颈反而越来越不在于 PIOC 本身。因此更合理的结论并不是“PIOC 做 IO 比主核快”,而是“在严格时序的 IO 时序场景下,PIOC 的设计更适合决定 IO 时序在什么时刻发生”。
所以,与其说 PIOC 比主核“更快”,不如说它把一件主核也能做、但不适合长期亲自做的事情,交给了一个专门负责这件事的执行单元。用一句未必准确但通俗的话来说,就是“术业有专攻”。
09 所以,我们到底烤出了什么?
看起来写到这里,我们的“蛋糕”已经烤好了,并且我们品尝了一下:SWD_Transfer 事务的位时序实现已经在 PIOC 上跑起来了,并且经过了完整的 CMSIS-DAP 端到端访存测试。回顾前面的内容,总结性地来问:我们折腾这么久,最后到底烤出了什么?
09.1 貌似不只是一个 PIOC 程序
总觉得我们不是在给一个小核写汇编,因为好像它与主核的交互方式已经不像一个“并肩运行”的小核了。
看起来我们做的事情只是把 CMSIS-DAP 里那段用 GPIO 逐位模拟 SWD 的 SWD_Transfer() 移植到 PIOC 上去执行。但是如果我们更详细地列出我们做了什么:
- 寄存器接口:命令、结果、参数、数据各有明确语义,其中命令寄存器和结果寄存器的读写行为与状态位联动
- 启动与完成语义:写命令即启动,写结果即完成,两侧通过状态位互相确认对方是否已经消费
- 配置方式:换向周期、空闲周期、数据阶段标识、SWCLK 延时,只在配置发生变化时写入一次
- 故障边界:超时判定、停止、复位、重新配置、回到就绪状态
- IO 控制权:PB10/PB11 在“主核的 GPIO”和“PIOC 的引脚”之间来回交接
- 高度确定的执行时间:实测在 21.276MHz SWCLK 频率下,每个位固定 9 个周期
然后,从这些特性反推,有没有觉得这个东西有一个很熟悉的名字?它们合在一起的效果是:对主核而言,它是一个先配置、再提交事务、然后等待完成(甚至被请求中断后再处理)、最后读走结果的功能单元。
迫真外设?
如果片上的一个通信外设代入以上特性来看,似乎大部分都是符合的,而且对于主核来说操作起来也像一个外设一样。
由此进一步抽象,主核眼中的外设一般像这样:
- 独立执行主要功能,不要求主核逐周期参与 IO 时序
- 明确的输入/输出接口
- 明确的启动/完成语义
- 明确的数据交换协议
- 独立的故障边界
- 主核不必了解内部时序实现
至于“必须是硬件实现”?主核可能并不关心,它甚至分辨不出来。真正不同的是:这段逻辑是否仍然属于主核自己的执行流。一个普通函数的调用边界和执行边界是重合的,主核调用函数执行时仍然在自己的时间线上运行;而对于 PIOC 实现的外设,主核提交完事务就可以处理别的事情,在合适的时候回来收结果,无论是阻塞轮询还是中断回调。也就是说,判断的关键是它有没有对主核形成一个稳定的功能边界,也就是有自己的接口、执行流、完成语义和故障边界。而且这些并不算是“事后找补”,每一条背后都有一个具体的问题要解决:
- 为了让主核能进行正确的事务同步:命令和结果机制
- 为了防止意外卡死:超时和恢复机制
- 为了让主核和它能分时复用同一对引脚:控制权交接
尽管最初动手写这段 PIOC 程序的时候,我们并没有有意识地将它变成一个“可编程外设”,但是资料包里的例程本来就是各种数字通讯接口的实现,我们也用过许多片上的通讯外设,“外设应该长什么样”几乎是不可避免的先入为主。所以更准确的说法是,上面这些约定确实是为了解决一个个具体的问题才出现的,而最后得到了一个“散发着外设香气的现烤蛋糕”并不是天马行空地折腾一番后的结果。与此同时,很重要的一点仍然不可忽视:PIOC 本身的确是独立的硬件资源,并且有高度确定性的时序。如果我们的实现只是在主核执行流里跑的一段被调用的代码,上面这些约定就只是一种“规范的、低耦合高内聚的”函数调用。
这样看来,“外设”这个词的范围似乎和我们想象的有一点不同:MCU 上的外设,必须是芯片级设计阶段就固化定型为硬件实现出来的东西吗?
09.2 把“外设定义”推迟到开发者动手的时刻
也就是说,这里被推迟的并不是“由硬件实现”,而是“必须在芯片设计阶段就定下来”。
回到本文开头的那个生日蛋糕,“PIOC 给了我们蛋糕的原料和烤箱,但是没有规定菜谱”。在那里,这句话是为了说明本文不会再照抄资料包里的现成例程再水一篇《PIOC 实现 XXX》。但是结合上一节最后的思考,“菜谱”可能并不只是“有没有规定”,还在于“何时被确定”。
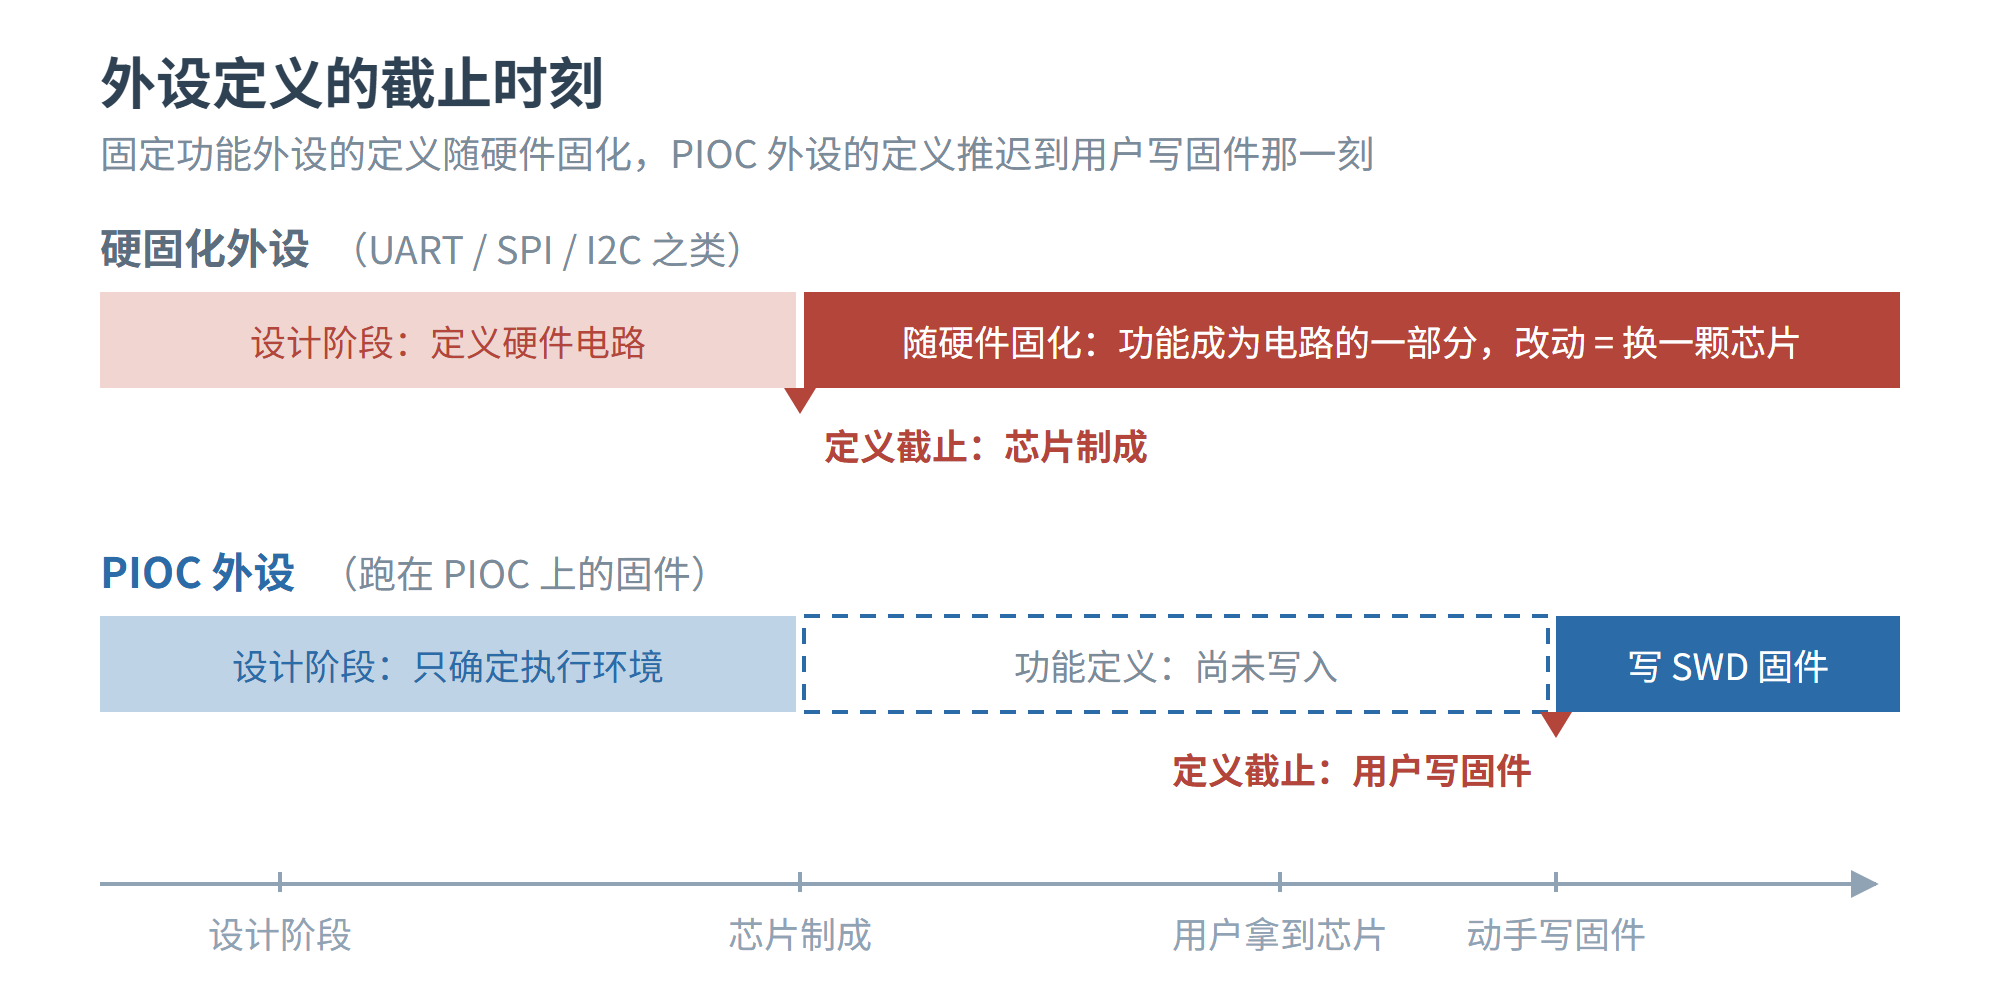
对于常规的“硬固化外设”,它的功能定义是完全依托于硬件实现的。功能和接口被做进电路之后,这份定义就成了硬件的一部分,随芯片一起交到用户手上。此后但凡想改一点设计时没有预留的东西,都只能换一颗芯片;即使是设计者后来改了设计、做了相应硬件修改,为了让这一修改生效,最后也还是需要让用户拿到一颗新的芯片来换。对于“硬固化外设”来说,手册能做的只是阐述那份定义,用户能做的只是品尝那个蛋糕,超出最初设计范围的事情是无法被保证的。
“没有硬件的支持,你破解个P!”——《流浪地球》
但对于 PIOC 来说,芯片设计阶段确定的只有执行环境本身(指令集、SFR、IO 引脚、程序空间),至于它将来会变成一个什么样的外设,则是“一张白纸”。它并不针对任何具体协议,因此设计阶段也没有必要知道将来会去实现什么。这份定义真正被写出来,已经是用户拿到芯片之后、写在固件里的了:手册中的命令与响应约定、功能与行为模式等,对常规的“硬固化外设”来说是厂家做好的预制品,在 PIOC 上却成了写程序的人自己的“选择”和“设计”。当然,PIOC 的底层仍然是一种被固化的硬件,它同样受执行环境的约束,只是这个执行环境给出的自由度,远超思维定势中“一个外设应该有的”。
这件事在 03 章里其实已经被隐约碰到过,只是那时还停留在“波形由谁来产生”的争论上。现在看来,“波形”只是这个争论最表面的现象,背后真正需要被定下来的,或许是这个外设的接口规范本身。也就是说,硬固化外设的“定义”在它被物理固化的那一刻就完成了;而跑在 PIOC 上的这个外设,它的定义被推迟到了有人动手写固件的那一刻才开始。
“废话,不写程序怎么用?”对,就是废话,固件没写完,外设当然“没烤熟”。
但重点在于这个开始时刻为什么落在这里:定义落在一段程序里,什么时候写、写成什么样,都由写程序的人自己决定。也就是说,这个外设的功能定义不是在动手之前就已经先定好的,而是和实现同时定下来的。
09.3 Software Defined Peripheral
前些年,“软件定义化”开始流行,“Software Defined XXX”的命名方式也流行起来,中文里通常叫“软件定义 XXX”,而它能持续到现在并指导成熟的技术路线,并不只是因为名字好听。软件定义无线电(Software Defined Radio,SDR)把一部分原本由固定硬件完成的无线信号处理,交给了可编程的数字部分;软件定义网络(Software Defined Network,SDN)则通过软件化的控制平面来重新定义网络设备的行为。它们共同表达的是同一种思路:底层硬件负责提供能力,而具体功能的一部分,被留到硬件出厂之后由软件继续定义。
显然本文的例子中,同样的事情又发生了:原先一个外设的功能定义随芯片一起交到用户手上,如今它存在于一段可以随时改写的程序里。所以我们也给这套玩法起了个名字,就是标题里那个 Software Defined Peripheral,软件定义外设。
需要说明的是,这是笔者为了描述这种奇妙的设计思路,而类比性地采用的一个概念性称呼,并不是芯片厂商官方正式提出的概念,也不是芯片手册中的标准术语。
不过,“软件定义”这几个字也很容易被理解偏,其中最容易混淆的一点,是“软件可配置”和“被软件定义”的区别。例如,一个 UART 外设的波特率、数据位、校验方式都能由软件设置,但无论怎么配,它仍然是一个 UART,寄存器语义、状态机、采样方式等在设计阶段都已经按照“一个合理的 UART 外设”定死,软件只是在既有范围内填参数,这仍然属于使用一个硬固化外设的范畴。而这里的情况是,连“这个东西到底是不是一个 UART”都没有在设计阶段被决定,用户编写 PIOC 固件实现特定的功能就进入了“软件定义”的范畴。
那么,软件 / 定义 / 外设,我们已经讨论过“外设”和“定义”,还剩“软件”这一点。
这里“软件”的含义,关键仍在于这份定义以什么形式存在。硬固化外设的定义一旦成为硅片上的物理电路连接,就再也动不了;而 PIOC 上的定义始终是一段程序,改这段程序就等于重新设计这个外设,硬件本身不需要动。
而且,整个外设都可以被修改。同一颗芯片的 PIOC,载入一份 SWD 时序固件,它就是一个调试桥;载入一份 WS2812 时序固件,它又成了灯带控制器;同一个主核固件里也可以先带上好几份 PIOC 固件按实际需要择一载入,需要换协议的时候只需将 PIOC 挂起,重新复制一下固件再重新启动就完成了。对于硬固化外设来说,再灵活的驱动也只能在硬件已经固化的行为边界之内操作;要获得这种“换个身份”的能力,唯一的办法是换一颗芯片。
同时,“软件定义”并不能简单地理解成“用软件模拟一个硬件外设”。尽管 bit-bang 是软件实现、任何一段用 GPIO 拼出来的协议实现都是软件实现,但 PIOC 与它们最重要的区别在执行环境:软件实现从主核的执行流里被剥离了出来,成为一个拥有稳定的时序、运行时专用的 IO、自己的程序逻辑的独立执行单元。
| 对照项 | 硬固化外设 | 主核上的 bit-bang | PIOC |
|---|---|---|---|
| 功能与接口定义的载体 | 设计阶段的硅片电路 | 主核程序 | PIOC 程序 |
| 改变功能的代价 | 只能换一颗芯片 | 改主核固件,改动留在主核执行流里 | 换一份 PIOC 固件,硬件不动 |
| 执行环境 | 专用电路,与主核完全独立 | 与系统其它任务共享主核 | 独立执行单元,与主核并行 |
| 时序归属 | 硬件自身的状态机 | 主核指令流的一部分 | 自己的指令流 |
| 主核需要知道什么 | 配哪个寄存器、读哪个状态位 | 每一位该怎么产生 | 提交什么命令、取回什么结果 |
所以,如果要把这套操作说得更严格一些(笔者个人的定义):
Software Defined Peripheral 并不只是“用软件模拟一个硬件外设”,而是:外设本身的功能、接口和时序行为,有相当一部分不在芯片设计阶段被固定,而是由一份可替换的软件程序定义,并由一个独立的可编程执行单元负责执行。
“纯手工创意烘焙现烤蛋糕?不是,你这个纯手工的意思怎么是自己烤啊?”
10 什么样的东西值得交给 PIOC?
既然 PIOC 能做这么多事情,那自然也可以反过来考虑它的边界:是不是所有东西都应该交给它?
10.1 不一定是“奇怪协议”,也可能是需求还没有稳定下来
在本文的开始,我们把这类没有被主流 MCU 支持的接口描述成“百花齐放、难以归并成一种固定的硬件实现”。这个说法是从我们看到的结果出发的,但有时产生这种情况的原因,就包括这些接口的需求本身就不够稳定。
调试的时候有句老话:不怕复杂的 bug,就怕复现不出来的 bug。再刁钻的问题,只要能稳定复现,总能一点点定位到根因;反而那种说不清触发条件、复现不了的问题,连“错在哪”都描述不出来更加棘手。而对芯片设计者来说,遇到这类接口时同样面临类似的处境。协议复杂本身算不上什么难题,但连“这个接口到底是什么”都没有成为一个稳定的需求的话,很可能变得非常棘手:
- 今天需要 A,下一版可能就需要 B,再下一版还要再加 C
- 不同客户需要的协议并不一样,甚至可能都难以用标准外设模拟
- 某个接口只需要两根 IO,但对时序的要求一点也不低
- 产品升级后还可能需要增加新的协议支持,甚至在不同工作模式之间切换协议
对硬固化外设来说,这里有一个先天的矛盾:硬件定义一旦完成,功能也就随之固定。为一个还没有稳定下来的需求单独做一套硬件,就像去修一个根本不知道什么原因导致且难以复现的 bug,需求本身还在变,做进硅片的这份定义很难保证还是对的;反过来,为每一种可能出现的需求都准备一套外设,显然也不现实。
PIOC 的意义恰恰在于把这个决定往后推:与其在芯片设计阶段就替用户决定“这个外设是什么”,不如先提供一块能够在出厂之后继续改变功能的可编程执行资源。巧合的是,04 章最后我们总结的“在设计芯片的时候,也就没有必要预先知道它将来会去实现什么”,当时只是从“协议可以拆成原语”顺带推出来的一句话,但是这里却出乎意料的解释了 PIOC 适合的一种场景。值得交给 PIOC 的,不一定是非标的接口,甚至有可能是那些在芯片设计阶段无法被确定下来的接口。
10.2 硬固化外设与可编程外设的取舍
要回答这个问题,也许我们可以先对比两者在各方面的差异:
| 对照项 | 硬固化外设 | 本文中的 CH32 PIOC |
|---|---|---|
| 位级波形 | 由专用时序逻辑产生,每位开销由该外设自身的协议要求决定 | 由程序逐条指令产生,每位开销与程序实现有关 |
| 数据搬运 | 可以提供 DMA、FIFO 等专用数据通路,使大量数据搬运不需要由主核逐项执行 | 只有 SFR 和中断请求,搬运需要主核参与 |
| 集成与维护 | 驱动与生态成熟,通常有现成的主核代码例程 | 要自己写固件、定义接口,主核固件里还会多出一份需要同步维护的二进制 |
| 验证责任 | 厂商负责完成硬件功能及规范行为的验证,用户主要验证驱动及系统集成 | 厂商验证执行环境,具体外设行为、时序和异常处理由固件作者负责验证 |
| 可移植性 | 同系列芯片通常可以复用驱动,但仍受具体外设寄存器和硬件差异影响 | PIOC 程序在相同执行环境下可以直接复用,具体 IO、时钟和主核接口仍需适配 |
| 功能可变性 | 硬件定义完成时功能随之固定 | 改程序即改功能,可应对多变需求 |
对于一个硬固化外设,其每位开销由它自己的协议要求决定。对 UART 来说,接收路径为了与输入的异步信号同步需要过采样,因此一位通常对应十几个时钟;对 SPI 主机来说,收发都同步到由外设时钟分频得到的 SCK,因此可以把时钟做到外设时钟的一半,一位只要两个时钟;对于带专用 PHY 或收发器的接口,硬件外设内部还可能包含复杂的编码、同步和收发逻辑,则更复杂。而对于 PIOC 来说,每位开销等于处理一位所需要的指令条数,本实现中经过实测的快路径是 9 个周期,而且这个数字会随程序的具体实现不同而变化。因此,无法一概而论“硬件比软件快多少倍”,这只能说明两边的时间开销各由不同的因素决定。
甚至说,如果把一个硬固化外设的 DMA 和 FIFO 移除,主核侧看到的使用方式可能其实和这里差不太多,一样要轮询或者等中断,一样要逐个数据搬运。所以差别不在“硬件支持 DMA 无需主核介入、PIOC 做不到”(要是以后真出了个带 DMA 的 PIOC,这一条都很难说了),而在于搬运开销由谁承担。有专用通路时,搬运可以不占用执行单元的指令周期,代价转移到总线带宽上;但对 PIOC 来说,数据只能通过 SFR 交换(它无法直接访问主核的内存),搬运就只能由主核承担。PIOC 能用的长数据只有主核写进它复用为 ROM 的那片内存的内容,而且对它来说是只读的(如第一篇中把上千个 WS2812 灯珠的 RGB 数据嵌进固件),可读写的暂存组件只有 SFR 和栈。
有趣的是,本文的 PIOC 程序最初并不是为 CH32V205 写的,而是在另一颗 CH32 芯片上实现的。后来移植到 CH32V205 时,甚至没有修改 PIOC 汇编本身,而是直接把原来的汇编程序复制过去了。原因并不是两颗 MCU 的“性能差不多”,恰恰相反,主频大约提高了 4 倍。但从 PIOC 自己的视角来看,两边支持相同的指令集,拥有相同的 SFR 和 IO 操作方式等,执行环境是一致的,因此程序并不知道自己被搬到 CH32V205 的 PIOC 上了。
但是 CH32V205 上 PIOC 的实际主频是原来的约 4 倍,导致 PIOC 的指令周期都缩短到原来的约 1/4,为了让时序参数符合预期,理论上是需要进行调整的。巧合的是,因为原先的程序中使用的延时量全部以 PIOC 周期表示,主核侧在计算这些参数时也全部使用当前 PIOC 的实际主频,这导致 PIOC 程序本身的定时和主频发生了解耦,主频变化最终被封装在主核配置频率时的“时间 → 周期数”换算中。
不过这同时也说明,即使两边的执行环境保持一致,也只是确保了 PIOC 程序本身能够直接迁移。但对于一个完整的 PIOC 外设来说,主核那一侧的实现(包括 GPIO 复用、初始化流程、时钟周期计算等)在换型号时都可能需要重新适配。巧了,硬固化外设也一样,换一颗芯片,驱动代码可能要按新的外设时钟结构重算分频。并且时钟周期计算如果不对,编译和运行都不会报错,只是跑出来的时钟频率和预期不一样。这简直太搞笑了!写起来像外设,跑起来像外设,错都可以错得和外设一样!
尽管表中对比的是位级波形、数据搬运、验证责任和可移植性等项目,但是这些差异对于硬固化外设和 PIOC 来说,很可能是同一个原因的产物:这个功能与接口究竟在什么时候、由谁定下来。硬固化外设把这份定义与硬件实现绑在一起,厂商可以围绕已知协议安排时序逻辑和数据通路,并完成相应验证;用户拿到的是一套已经确定的功能。而对 PIOC 来说,厂商则只把执行环境固定下来,具体接口、命令与数据语义、时序和异常处理,要等到写固件时才由使用者定义。它换来了“改一份固件就等于换一个外设”的余地,也把实现、验证和维护一并留在了固件这一侧。
这种灵活性最容易显出价值的场景显然是应对多变的需求,但这并不等于只有尚未定稿的协议才适合 PIOC。例如,本文的 SWD 早有成熟规范,但我们选择 PIOC 并不是为了重新定义 SWD,而是因为 CH32V205 上没有可供这个调试桥使用的 SWD 主机外设;并且主核中已有能工作的 bit-bang 实现,其中反复执行的 SWD_Transfer() 正好可以从主核执行流中分离并下沉到独立组件中实现。也就是说,协议是否成熟只是问题的一部分;现有资源是否合适、实时部分能否独立出来,同样决定了 PIOC 是否更适合。
因此,下面几种情况往往会提示我们可以把目光投向 PIOC:
- 直到硬件选型结束也无法确定协议:规范尚未定稿,或者不同版本的产品之间接口要求不同,如果需要把定义做进硬件就可能变成沉没成本。
- 协议不常见、时序却不宽松:只有一两根信号线,但对边沿或时隙的要求一点也不低。
- 要支持的接口有好几套,但很少同时用:硬件外设的种类和数量很难一次配齐,固件却可以按需换一份。
- 手上已经有能跑通的软件实现:主核上的 bit-bang 已经工作,其中负责 IO 时序的那部分能单独拎出来。
这些只是“把定义留在固件里”可能更合适的迹象,并不是一张“满足条件就立即使用 PIOC”的量表。引入一个独立的可编程组件,也意味着需要有人负责它的固件开发、时序验证、与主核工程的集成和长期维护。这就像在家里养猫:不能只喜欢有猫陪着,却不料理它的吃喝和卫生,也不打扫满地的猫毛。同样地,PIOC 给了我们自己定义外设的自由,也就意味着实现、验证和维护这份“外设固件”的责任要由开发者自行承担。事物总是两面的,想要哪一面,本来就不可能把另一面一起丢掉。至于某个实现最终能否装进 PIOC,还要受程序空间、可用 IO、数据处理和执行速度等资源边界制约。
10.3 PIOC 甜点区的边界
肯定有读者觉得我这篇文章像 PIOC 的软文,肯定要大吹特吹 PIOC。HDM 你广告费结一下(小声)
“喂,你在这里玩 PIOC 玩的很开心嘛!”好的,那笔者就要把一大盆冷水端上来了!
PIOC 的甜点区基本上是“少量 IO、短而严格的时序、有限的状态和不太重的数据处理”。本文的 SWD 正好落在这里,两根线上的一次事务虽然有换向、分支和校验,却可以在很小的状态空间里完成;主核只需要在事务边界与它交换参数和结果。超出这个范围以后,PIOC 仍可能写得出程序,但可能需要工程上不划算的代价。
比如说:
- 需要多条并行数据线的接口。 当前的 PIOC 实现只有两个 IO。QSPI、各种并口或 RGB 屏这类接口所需的信号数量首先就超过了它能够直接控制的范围,属于硬限制。
- 大吞吐的数据搬运。 PIOC 一般不能直接访问主核的 SRAM,数据通常只能经 SFR 与主核交换;它没有 FIFO、DMA 这样的专用数据通路。复用为 PIOC 程序 ROM 的那片主核 SRAM 可以预先放入只读数据,PIOC 也能用
RDCODE读取,但一次读取需要 2 个周期,且运行期间不能写入。因此它能服务固定的波形表或常量数据,却不能替代可双向访问的大容量缓冲区。对于持续的大块数据,握手和搬运仍会很快成为系统中的显著成本。 - 需要大量运算或中间状态的处理。 2047 条指令的程序空间、没有独立 RAM 的条件,以及很有限的栈和寄存器资源,决定了它适合紧凑的状态机,而不是把复杂协议栈或大量缓存一并塞进去。
- 位周期已经逼近指令开销的接口。 PIOC 的时序虽然可预测,但每一个位仍要由指令一条条做出来:取数据、给出边沿、判断并累加校验,这些动作都不能凭空消失。一个位最终占几个周期,取决于这些操作的开销和程序怎样安排,而不是一个可以随意取小的常数;本文实测的每位 9 个周期只是当前实现的结果,继续重写还能再压缩一些,但往往是在其它时序余量中继续抠。如果这个接口处在从机一侧,情况会更严峻:总线节奏由主机掌握,PIOC 必须在对方给定的窗口内完成采样和判断,可以抠的余量比主机侧更少。
- 以长时间跨度的时间保持为主要任务。 PIOC 很擅长用确定数量的指令安排 IO 边沿,但如果任务本身只是等待很长时间,再在某个时刻产生事件,那么把这样一个执行单元长期占住,通常不是最经济的做法;定时器、RTC、DMA 等硬件机制更合适。
- 需要同时常驻多套彼此独立、复杂的自定义协议处理逻辑的场景。 程序空间、状态保存和时序调度都会迅速成为限制。
除了 IO 数量这类硬边界在当前的 PIOC 实现下是“一票否决”的,其余很多情况即使越过了上述的边界,也有可能做出能用的波形,只是会在带宽、程序空间、主核协同或维护成本上付出过高代价。从整体工程的规划角度来看,可能比“PIOC 能不能实现 XXX”更需要关注的问题是“把这个接口交给它之后是否能让整个系统的设计变得更好”。
这也是“甜点区”这个名字的直观阐释:既能烤得出来、又值得为此动一次烤箱的范围,本来就只是中间那一小片。PIOC 对于这类应用需求做起来既不勉强也不浪费;在“甜点区”之外的情况,波形未必做不出来,只是投入与产出可能会越来越不成比例。
11 结语:原来还要自己烤?
本文从主核上已经跑通的 SWD 软件实现出发,把其中反复执行的 SWD_Transfer() 交给 PIOC,让主核不再亲自完成每一位的 IO 时序。
MCU 上没有需要的外设怎么办?也不是不可以自己烤一个。
开头那个“Linux 的生日蛋糕”并不是为了吐槽说 PIOC 用起来麻烦。硬固化外设像一块已经烤好的蛋糕,拿到手就知道它是什么,但也就只能品尝烤好的蛋糕而已;PIOC 给我们的则是烤箱和原料,不预先替我们定好菜谱。SWD 是已经有成熟规范的数字协议,我们也没有重新发明它,在 CH32V205 这颗 MCU 没有对应外设的时候,我们通过 PIOC 把这份已有的软件实现变成了一个独立工作的功能单元。
在示波器上看到正确的 SWD 波形,还只能说明烤出来的东西“像个蛋糕”;但如果要“端上桌品尝”,主核得能把事务交给 PIOC 并且拿到结果,接进 CMSIS-DAP 后,OpenOCD 还得能照常使用它。直到这些端到端实现全部完成,主核面对的就是一个有明确接口和执行边界的功能单元,而不只是一段产生波形的程序。尽管芯片手册里原本没有这样的组件,但从主核的使用方式来看,它已经是一个外设了。第 09 章给它起的名字是软件定义外设,Software Defined Peripheral,也就是“硬件给出了执行环境,至于这个外设具体是什么,留到写程序时再决定”。
当然,既然是自己动手烤的,固件开发、时序验证、调试与维护这些代价前面已经谈过,不是每次都值得付。但如果所需的功能恰好落在 PIOC 能力范围内,除了挑一颗已经做好这种外设的 MCU,我们有时候也不是不可以自己动手烤一个。
附录 A:DELAY_L2 周期数推演
本附录给出 08.2 中 DELAY_L2 调用开销的完整推导过程。正文只保留了结论,逐条指令的推演放在这里。
由于本文篇幅较长,为方便读者阅读,这里再次贴出 DELAY_L2 的汇编代码:
1 | DELAY_L2: MOV DAP_DELAY_CYC_D1,A |
阅读一份代码,往往是从控制流开始下手。让我们先看这个子程序的控制流结构。
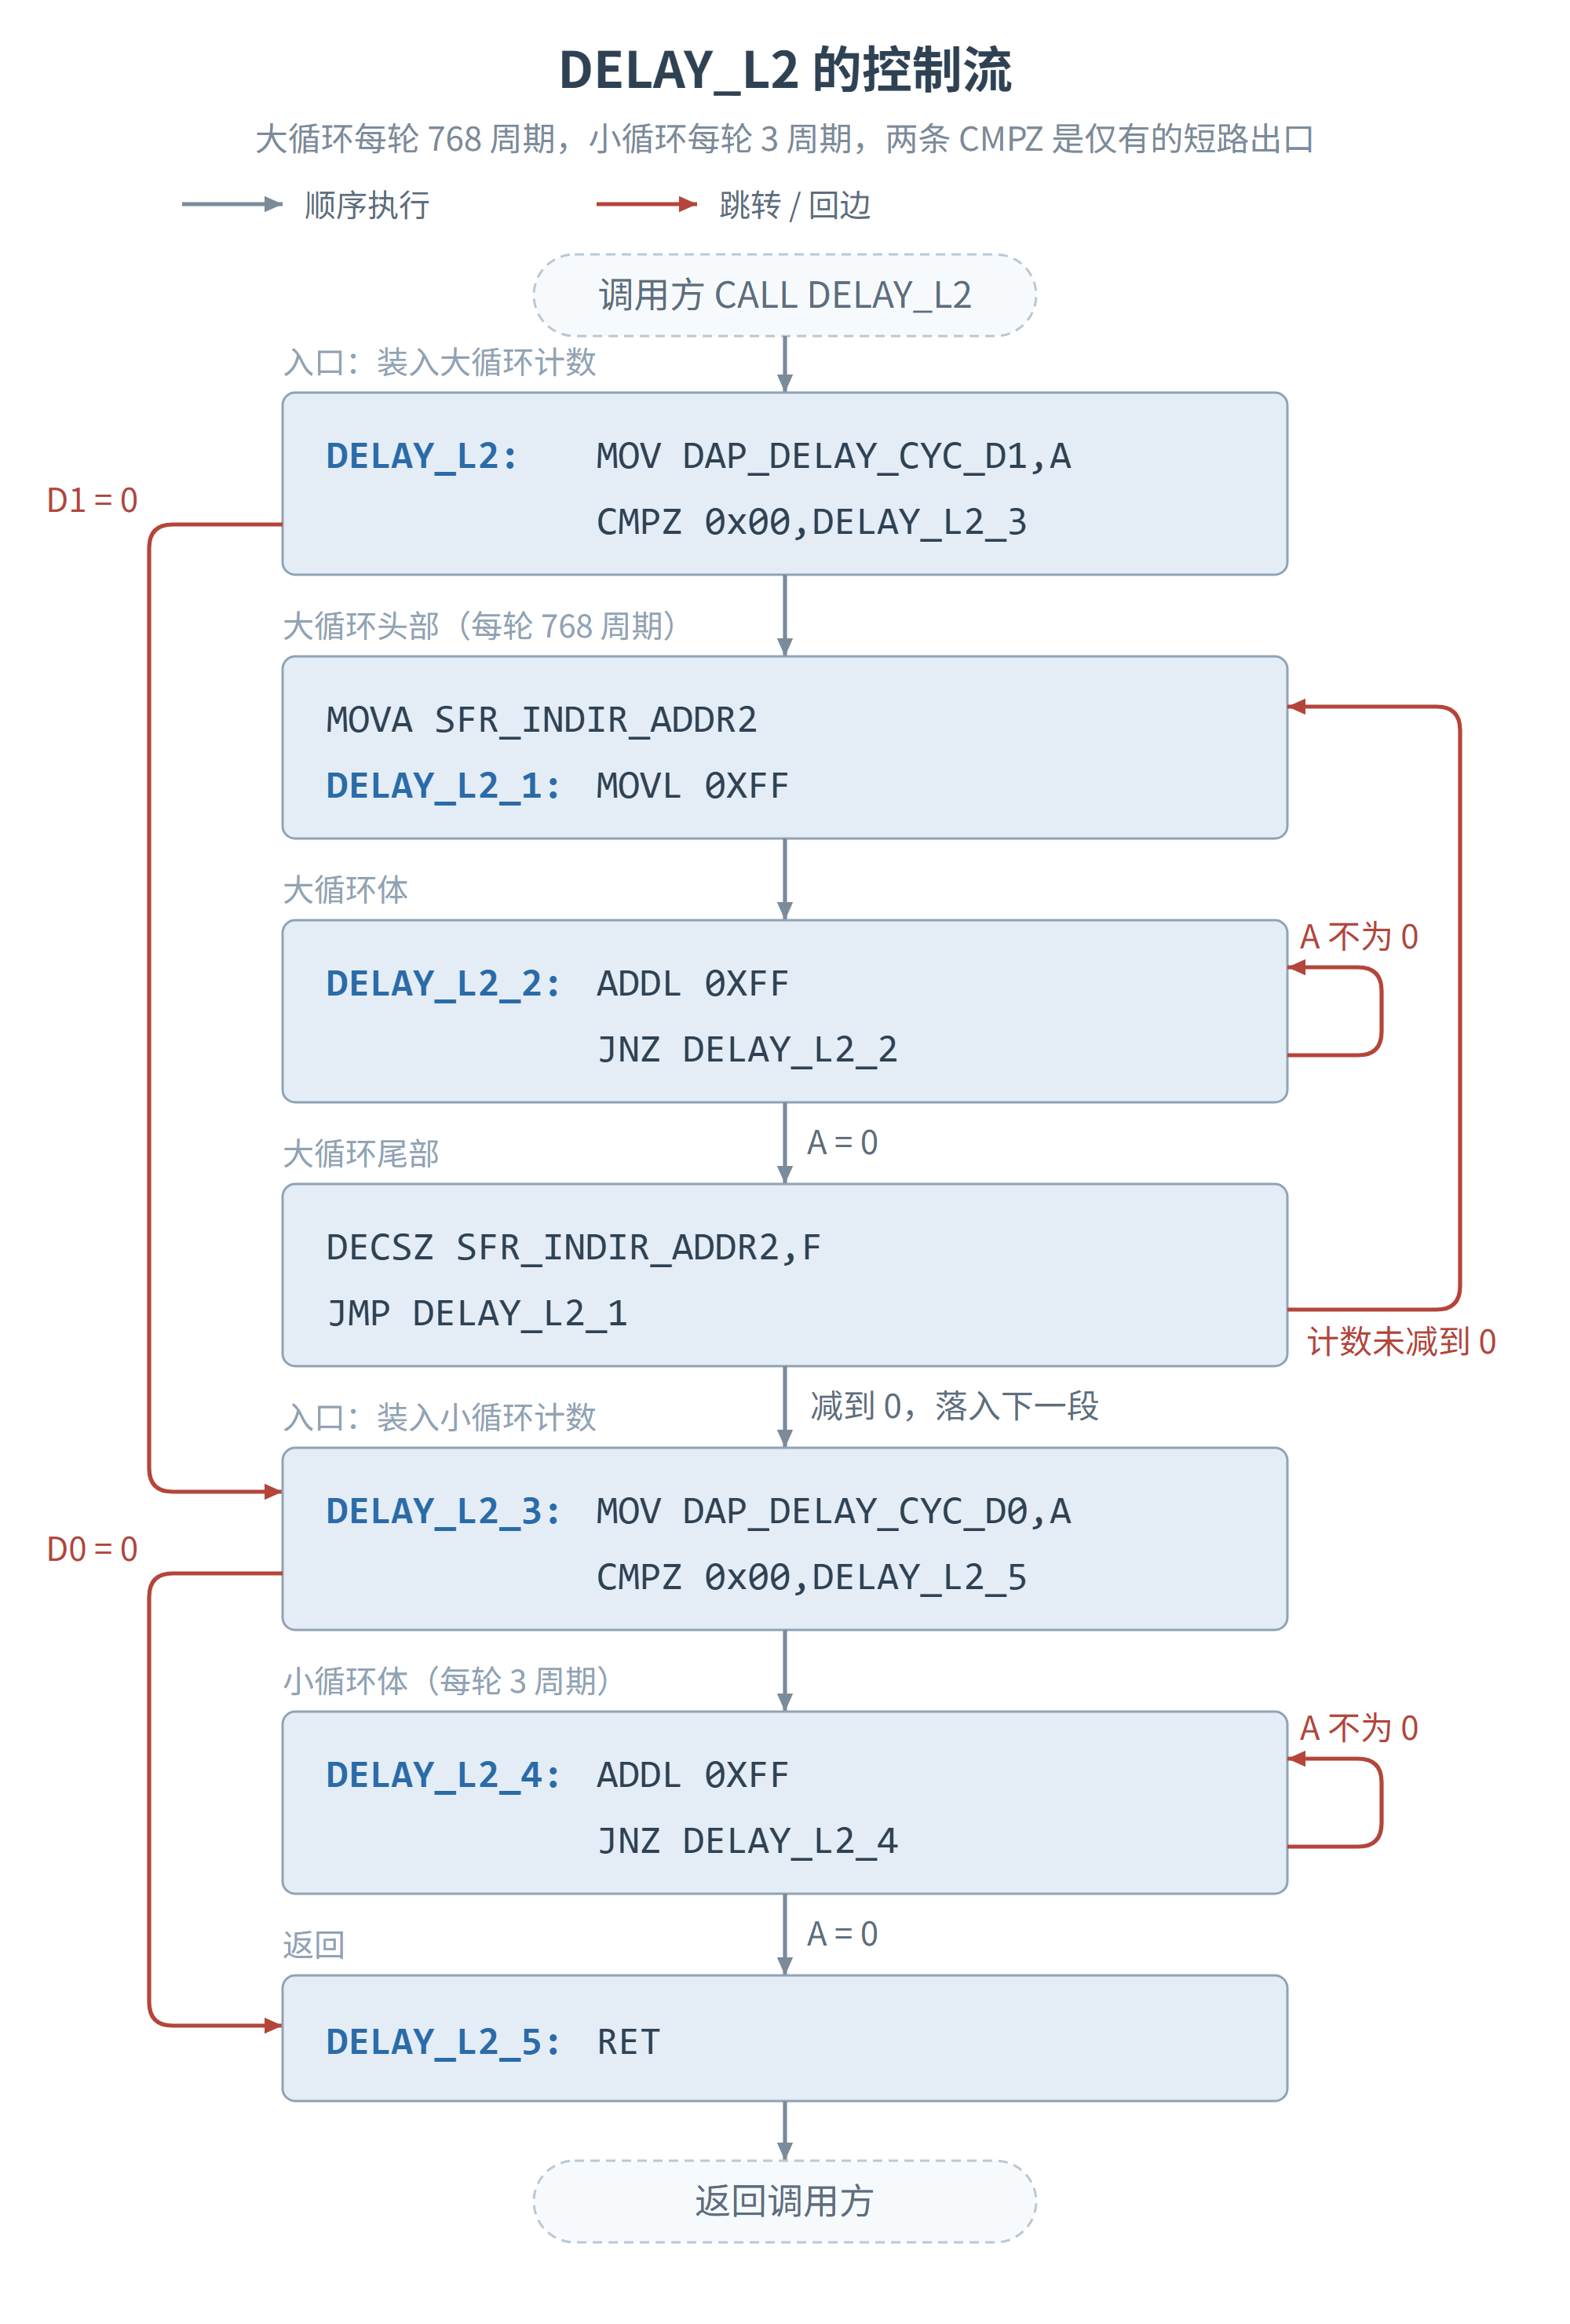
DELAY_L2 的控制流可以抽象为两个循环,第一个循环每轮消耗 768 周期,称为“大循环”,轮数由 D1 控制;第二个循环每轮消耗 3 周期,称为“小循环”,轮数由 D0 控制。首先考虑 D0 和 D1 都大于 0 的情况。DELAY_L2 到 DELAY_L2_1 之前的这部分主要是初始化和 D1=0 的条件判断。
| 指令 | 周期数 | 说明 |
|---|---|---|
DELAY_L2: MOV DAP_DELAY_CYC_D1,A |
1 | 将 D1 装入 A 用于比较 |
CMPZ 0x00,DELAY_L2_3 |
1(跳转条件不满足) | 与 0 比较,若 A=0 则跳转到 DELAY_L2_3 |
MOVA SFR_INDIR_ADDR2 |
1 | 将 A 的值(D1)装入外层循环计数器 |
| 合计 | 3 | - |
DELAY_L2_1 到 DELAY_L2_3 之前这一段是大循环,在这一段被执行的指令按顺序如下(控制流转移到此处时确保 D1>0):
| 指令 | 周期数 | 说明 |
|---|---|---|
DELAY_L2_1: MOVL 0XFF |
1 | 给内层循环计数器 A 装入初值 0xFF |
DELAY_L2_2: ADDL 0XFF |
1 | 内层循环计数器 A 减 1(影响 Z) |
JNZ DELAY_L2_2 |
2(跳转条件满足) | 若上次自减后 A 非零则跳转到 DELAY_L2_2 |
| … | … | 内层循环的重复 |
DELAY_L2_2: ADDL 0XFF |
1 | 内层循环计数器 A 减 1(影响 Z) |
JNZ DELAY_L2_2 |
1(跳转条件不满足) | 此时 A 已经为 0,条件跳转不发生,继续向下执行 |
DECSZ SFR_INDIR_ADDR2,F |
1(跳转条件不满足) | 外层循环计数器计数减 1,若为零则跳过下一条指令 |
JMP DELAY_L2_1 |
2 | 回到外层循环开头 |
| … | … | 外层循环的重复 |
DELAY_L2_2: ADDL 0XFF |
1 | 内层循环计数器 A 减 1(影响 Z) |
JNZ DELAY_L2_2 |
1(跳转条件不满足) | 此时 A 已经为 0,条件跳转不发生,继续向下执行 |
DECSZ SFR_INDIR_ADDR2,F |
2(跳转条件满足) | 此时外层循环计数器计数减 1 后已经为零,跳过下一条 JMP 指令 |
| 合计 | 768×D1 | - |
容易发现,程序在 DELAY_L2_2 处的内层循环被重复了多次,而 DELAY_L2_2 处开始的整个大循环又被重复了多次,且计数器初值是 D1,这意味着大循环的循环次数是关于 D1 的一次多项式。先考虑平凡情况下(JNZ 跳转条件满足的情况总是多数,只有最后一次不满足)一轮内层循环消耗的周期数:
| 指令 | 周期数 | 说明 |
|---|---|---|
DELAY_L2_2: ADDL 0XFF |
1 | 内层循环计数器 A 减 1(影响 Z) |
JNZ DELAY_L2_2 |
2(跳转条件满足) | 若上次自减后 A 非零则跳转到 DELAY_L2_2 |
| 合计 | 3 | - |
这样的平凡情况会重复 254 次(计数器从 0xFF 递减到 0x01),因此消耗 3×254 周期。再考虑非平凡情况下(最后一次 A 递减后为零,JNZ 跳转条件不满足)最后一轮内层循环消耗的周期数:
| 指令 | 周期数 | 说明 |
|---|---|---|
DELAY_L2_2: ADDL 0XFF |
1 | 内层循环计数器 A 减 1(影响 Z) |
JNZ DELAY_L2_2 |
1(跳转条件不满足) | 此时 A 已经为 0,条件跳转不发生,继续向下执行 |
| 合计 | 2 | - |
结合起来,大循环中的内层循环全部轮次执行完成需要消耗 3×254+2=764 周期。然后再考虑平凡情况下(DECSZ 跳转条件不满足)一轮大循环消耗的周期数:
| 指令 | 周期数 | 说明 |
|---|---|---|
MOVL 0XFF |
1 | 给内层循环装入初值 0xFF |
| 内层循环 | 764 | 255 次 ADDL + 254 次跳转 + 1 次不跳转 |
DECSZ SFR_INDIR_ADDR2,F |
1(跳转条件不满足) | 外层循环计数器计数减 1,若为零则跳过下一条指令 |
JMP DELAY_L2_1 |
2 | 回到外层循环开头 |
| 合计 | 768 | - |
这样的平凡情况会重复 D1-1 次(计数器从 0xFF 递减到 0x01),因此消耗 768×(D1-1) 周期。再考虑非平凡情况下(最后一次外层循环计数器递减后为零,DECSZ 跳转条件满足)最后一轮大循环消耗的周期数:
| 指令 | 周期数 | 说明 |
|---|---|---|
MOVL 0XFF |
1 | 给内层循环装入初值 0xFF |
| 内层循环 | 764 | 255 次 ADDL + 254 次跳转 + 1 次不跳转 |
DECSZ SFR_INDIR_ADDR2,F |
2(跳转条件满足) | 此时外层循环计数器计数减 1 后已经为零,跳过下一条 JMP 指令 |
| 合计 | 767 |
结合起来,大循环中的内层循环全部轮次执行完成需要消耗 768×(D1-1)+767 = 768×D1-1 周期。
然后程序会执行到 DELAY_L2_3,这也是 D1=0 情况下跳转到的目标。这里会进行一些初始化和 D0=0 的条件判断:
| 指令 | 周期数 | 说明 |
|---|---|---|
DELAY_L2_3: MOV DAP_DELAY_CYC_D0,A |
1 | 将 D0 装入 A 用于比较 |
CMPZ 0x00,DELAY_L2_5 |
1(跳转条件不满足) | 与 0 比较,若 A=0 则跳转到 DELAY_L2_5 |
| 合计 | 2 | - |
然后执行到 DELAY_L2_4 的小循环,其控制流结构与大循环的内层循环类似,只是轮数由 D0 控制。平凡情况下的一轮消耗 3 周期,非平凡情况下的一轮消耗 2 周期。由于装入循环计数器 A 的初值是 D0,因此小循环的总消耗是关于 D0 的一次多项式 3D0 - 1。最后执行到 DELAY_L2_5,程序返回:
| 指令 | 周期数 | 说明 |
|---|---|---|
DELAY_L2_5: RET |
2 | 返回栈中保存的调用点下一条指令处执行 |
| 合计 | 2 | - |
再考虑到 CALL DELAY_L2 调用时是开销,于是整个 DELAY_L2 在 D1 和 D0 均大于 0 的情况下:
- 调用者调用:2 周期
- 初始化:3 周期
- 大循环:768×D1-1 周期
- 初始化:2 周期
- 小循环:3D0-1 周期
- 返回:2 周期
同理计算其它情况,即可列出 08.2 中给出的那张表:
| D0>0 | D0=0 | |
|---|---|---|
| D1>0 | 768×D1+3×D0+7 | 768×D1+9 |
| D1=0 | 3×D0+8 | 10 |